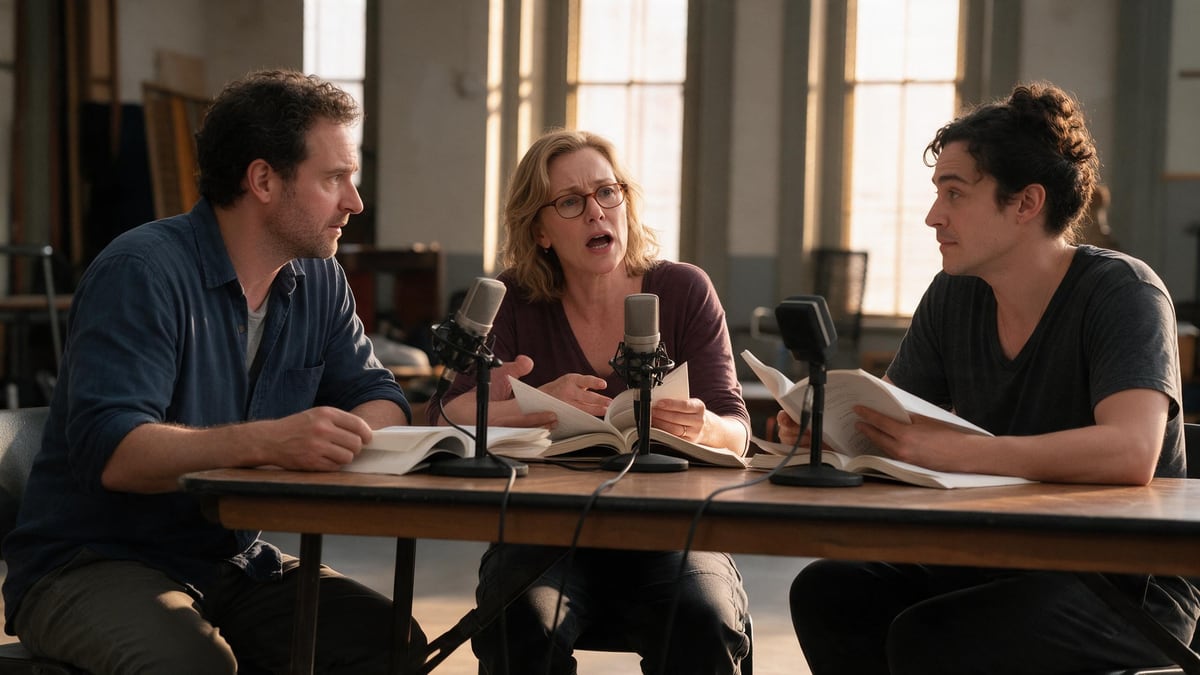
قراءة مشهد حواري
هذا هو العرض التوضيحي: عشر جمل، شخصيتان وسارد، لقطة واحدة. لمشهد أطول، node صوت مضاعفان بعشر جمل كل واحد، متتاليان في node مونتاج.
السيناريو بصيغة PDF يُسحب إلى لوحة العمل: node نص واحد يستخرج منه عشر جمل جاهزة للقراءة، سارد للأحداث الأساسية وشخصيات تنطق كلماتها كما وردت، ثم node صوت في وضع الحوار يؤديها في لقطة واحدة بثلاثة أصوات من ElevenLabs. القراءة التي تقومون بها مع الممثلين، في ثلاث نقرات. سير العمل كاملاً مرئي دون حساب.
سير العمل الحقيقي: السيناريو الأصلي المكوّن من ثلاث مشاهد بصيغة PDF في node وسائط، Claude Sonnet 5 لاستخراج العشر جمل، node صوت في وضع الحوار على ElevenLabs Dialogue v3 بثلاثة أصوات. النصوص المعروضة هي إجابات النماذج، دون أي تعديل.
باختصار
الحوار لا يُقيَّم إلا بالأذن. ملف PDF الخاص بالسيناريو يدخل إلى node وسائط، ويقرأه node نص عبر مدخله "صورة أو PDF للتحليل" لاستخراج عشر جمل بصيغة الاسم: النص: سارد يذكر الحدث الأساسي في جملة واحدة، وشخصيات تنطق كلماتها حرفيًا كما في النص.
node الصوت في وضع الحوار يحمل هذه العشر جمل، كل واحدة بصوتها، وElevenLabs Dialogue v3 يؤديها في تمريرة واحدة: التتابع، الصمت، وتبادل الحديث كلها تأتي من النموذج، لا من مونتاج. ثلاثة أصوات في العرض التوضيحي: سارد بصوت عميق، صوت امرأة ناضجة لماران، وصوت شاب لإلياس.
العرض التوضيحي يقرأ المشهدين 2 و3 من "North of Silence"، السيناريو الأصلي لقالب تحويل السيناريو إلى فيلم. عشر جمل لكل node: للمشهد التالي، كرّروا node الصوت وألصقوا فيه العشر جمل التالية، التي كتبها node النص. استبدلوا ملف PDF بسيناريو خاص بكم والأسماء في التعليمات.
هذه هي ملفات مسار العمل أعلاه، كما أنتجتها النماذج تمامًا، دون أي تعديل. تتم الإشارة إلى نقطة البداية عند وجودها.
النتيجة
كتّاب السيناريو، كتّاب المسرح وكتّاب الأعمال الروائية الذين يريدون الاستماع إلى حوار قبل إعادة كتابته أو تسليمه لممثلين لقراءته.
سيناريو أو فصل بصيغة PDF نصي: الأسماء بحروف كبيرة والعناوين الفرعية للمشاهد تساعد على فصل الأحداث عن الجمل.
اسحبوا السيناريو بصيغة PDF
يستقبله node وسائط. يُفضَّل تنسيق السيناريو الكلاسيكي: الأسماء بحروف كبيرة والعناوين الفرعية للمشاهد تساعد النموذج على فصل الأحداث عن الجمل.
اتركوا node النص يكتب الجمل
عشرة أسطر بصيغة الاسم: النص، مع ذكر المشاهد المطلوب قراءتها وأسماء شخصياتكم في التعليمات. NARRATOR يلخص الحدث، والشخصيات تنطق كلماتها حرفيًا.
ألصقوا الجمل في node الصوت
node الصوت في وضع الحوار له أسطره الخاصة: جملة واحدة لكل سطر، وصوت واحد لكل شخصية يُختار من القائمة. عشرة أسطر لكل node؛ node ثانٍ للمشهد التالي.
استمعوا، ثم عدّلوا
لقطة واحدة تؤدي كل التبادل. جملة تبدو باهتة: أضيفوا وسم أداء، [sighs] أو [whispers]، في النص. صوت لا يناسب: غيّروه في السطر، لا في كامل node.
لوحة العمل نفسها، مضبوطة لاحتياجات مختلفة: كل نمط يتطلّب تغيير سطرين أو ثلاثة في الـ prompt.
هذا هو العرض التوضيحي: عشر جمل، شخصيتان وسارد، لقطة واحدة. لمشهد أطول، node صوت مضاعفان بعشر جمل كل واحد، متتاليان في node مونتاج.
فصل من رواية بصيغة PDF يصلح أيضًا: السارد يقرأ النثر، والشخصيات تقرأ الحوارات بين علامات التنصيص. اطلبوا من node النص الحفاظ على الجمل بحرفيتها.
فقاعات صفحة، واحدة لكل سطر مع اسم الشخصية: node الصوت يؤدي الصفحة، وnode مونتاج يعرضها على الشاشة مع الصوت.
كرّروا node الصوت وغيّروا فقط صوت شخصية واحدة في كل نسخة: ثلاث لقطات، ثلاث نبرات، والمقارنة تتم بالأذن في دقيقة واحدة.
اطلبوا من node النص ترجمة الجمل وضبط لغة node الصوت: ElevenLabs Dialogue يؤدي أربع عشرة لغة، بنفس الأصوات.
وضع الحوار يستوعب عشر أسطر لكل لقطة. مشهد من ثلاثين جملة يعني ثلاثة nodes صوت، مرتبطة في node مونتاج بنصف ثانية صمت بين اللقطات.
نبرتان متشابهتان تُسمعان كمونولوج. اختاروا صوتًا عميقًا وصوتًا واضحًا، أو امرأة ورجلًا، قبل البحث عن فروق أدق.
على السارد أن يذكر الحدث في جملة واحدة، لا ملاحظات السيناريو بين الأقواس. تعليمات node النص تطلب ذلك: تحققوا من العشر جمل قبل اللصق.
لأن وضع الحوار يحمل أسطره بصوت واحد لكل منها، عشرة على الأكثر لكل لقطة: هذا ما يؤديه النموذج في تمريرة واحدة. node النص يحضّرها بالتنسيق الصحيح، واللصق يستغرق عشر ثوانٍ.
نحو عشرين نبرة من ElevenLabs، بعدد الشخصيات في العشر جمل. ثلاثة في العرض التوضيحي: السارد، ماران، إلياس. الأصوات ذات النبرات المتباينة تُميَّز أفضل من مونولوج.
نحو عشرة أرصدة لعشر جمل: قراءة PDF بواسطة Claude Sonnet 5 والحوار على ElevenLabs، تُحسب بالحرف. السعر يظهر على node قبل النقر.
نعم: صوت مستنسخ من مكتبتكم يُختار في سطر كأي نبرة أخرى. استنسخوا الصوت أولًا في node تعليق صوتي، ثم اسندوه إلى الشخصية.
النموذج يضع فترات التنفس بنفسه. لصمت حقيقي، قسّموا القراءة إلى نودين وأتركوا ثانية بينهما في المونتاج.
لغة الجمل، المضبوطة على node الصوت: الإنجليزية في العرض التوضيحي، مع توفر أربع عشرة لغة. سيناريو بالفرنسية يُقرأ بالفرنسية، بنفس الأصوات.
نعم: node مونتاج بغلاف أو صورة من المشهد كمقطع، والقراءة على المسار الصوتي، يصدّر ملف mp4 لشبكات التواصل أو ملف إنتاج.
جعل سيناريو يُقرأ بأصوات متعددة بالذكاء الاصطناعي
استخدام سير العمل هذاحساب مجاني، دون بطاقة بنكية. يُفتح سير العمل معبّأً مسبقًا في لوحة عملك.
 ElevenLabs Dialogue v3
 Claude Sonnet 5
 Grok TTS