Синтетический ведущий произносит ваш сценарий в камеру своим голосом. Veo 3.1 генерирует картинку и речь одновременно, поэтому губы попадают точно. Workflow виден здесь, без регистрации.
Интерактивное демо
Настоящий воркфлоу, реальные результаты. Двигайте холст и приближайте как угодно.
Карточка-референс держит лицо, нода Текст несёт сценарий, нода Видео выдаёт восемь секунд с голосом. Ноды Озвучка нет: речь выходит из видеомодели. Откройте ноды, чтобы прочитать промпты.
Коротко
Вы предоставляете
1 карточка-референс (фото и описание) · текст или бриф
Что выдаёт воркфлоу
1 изображение в 9:16 · 1 видео по 8 с в 720p, формат 9:16
Структура холста
5 нод, связанных 2 соединениями
Подключённые модели
Seedream 5 Pro, Veo 3.1 Fast
Стоимость полного прогона
около 149 кредитов, то есть 1,79 $
Учётная запись
Демо доступно для просмотра без учётной записи; для генерации нужна бесплатная учётная запись, пробные кредиты включены
Говорящий аватар всегда упирается в одно: липсинк. Классические цепочки генерируют немое видео, отдельно делают голос, потом пытаются склеить, и остаётся та самая десятая доля секунды рассинхрона, по которой всё сразу читается как подделка.
Здесь речь и картинка выходят из одного рендера. Veo 3.1 Fast генерирует диалог вместе с видео: губы следуют за голосом, потому что их посчитали вместе. Взамен смена одного слова означает новый рендер, поэтому сценарий фиксируется до запуска, и именно поэтому он живёт в собственной ноде Текст, редактируемой без вмешательства в персонажа.
Лицо держит карточка-референс с тремя ракурсами, та же механика, что и в сохранении персонажа на нескольких планах. Так вы делаете целую серию с одним ведущим, выпуск за выпуском. Seedream 5 Pro собирает исходный кадр, а открытый калькулятор показывает точную стоимость дубля до всякой регистрации.
Реальные результаты из демо
Это файлы workflow'а, показанного выше, в том виде, в котором их выдали модели, без ретуши. Исходная точка указана, если она есть.
Исходная точка
ВедущаяВедущаяВедущая
Результат
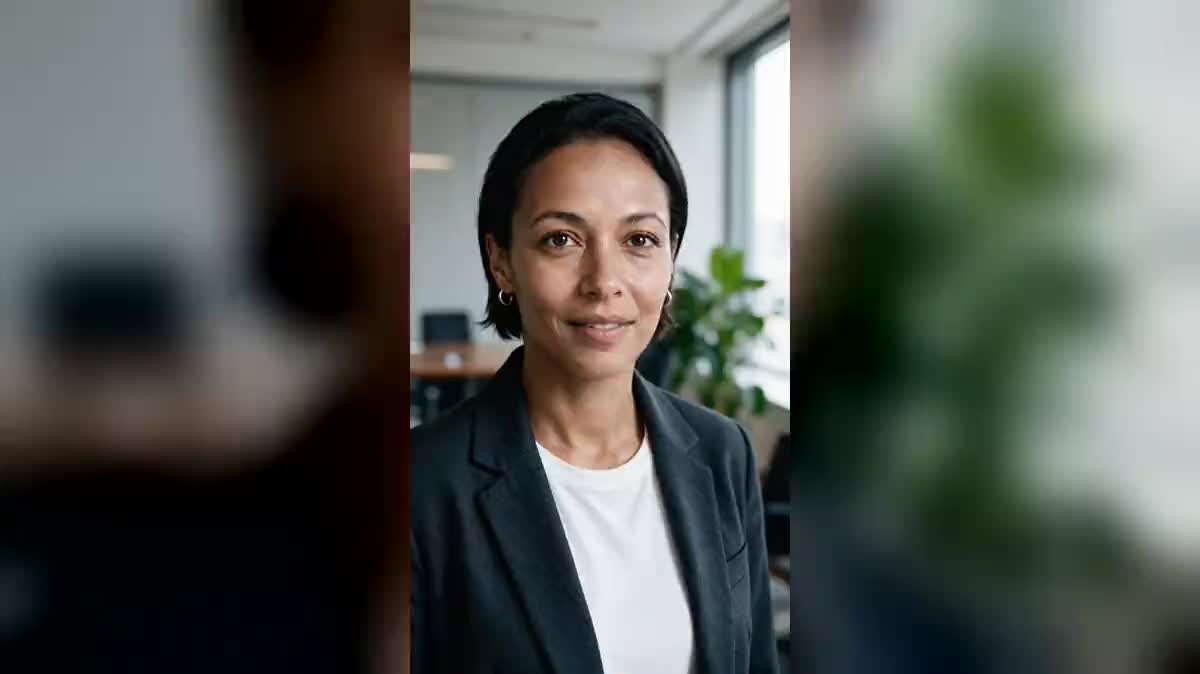
Сгенерированный начальный кадр: ведущая в кадре по грудь в светлом офисеСоздано с помощью Seedream 5 ProВидео: она произносит текст сценария на камеру, голос сгенерирован прямо в видеоСоздано с помощью Veo 3.1 Fast
Как это сделать
1
Создайте ведущего
Карточка-референс несёт три вида лица. Именно она позволяет получить того же человека в следующем выпуске, с другим фоном и другим текстом.
2
Соберите кадр
Нода Изображение задаёт сцену: стол, свет, место под экранный текст. Поясной план со смещением от центра оставляет пространство для жестов.
3
Напишите реплику
Нода Текст содержит режиссуру и саму фразу в кавычках. Двух коротких предложений хватает на восемь секунд, а интонация описывается как актёрская задача.
4
Снимите дубль
Восемь секунд, вертикальный формат, звук включён. Голос приходит внутри видеофайла: синхронизировать нечего, и монтировать нечего, если дубль удачный.
Варианты и сценарии использования
Тот же холст, настроенный под разные задачи: в каждом варианте меняются две-три строки промпта.
Аватар-ведущий для онлайн-курса
Учебный модуль режется на восьмисекундные отрезки, каждый в своей ноде Видео, и все они подключены к одной карточке лица. Ведущий остаётся тем же от главы к главе, чего ни одна серия реальных съёмок за эти деньги не гарантирует.
Лицо бренда
Одно и то же лицо открывает каждое видео компании, не завися ни от занятости сотрудника, ни от его ухода. Одежду и обстановку опишите в ноде Изображение: карточка держит лицо, кадр держит контекст.
Аватар, говорящий на другом языке
Напишите реплику в кавычках на нужном языке: Veo 3.1 Fast произнесёт её вместе с артикуляцией. Одно видео так раскладывается на пять рынков: тот же ведущий и пять разных реплик.
Приветственное видео на странице сайта
Восемь секунд, поясной план, размытый офис на фоне: формат, который увеличивает время на главной странице. Держите фразу короткой, одна мысль на видео, и заложите субтитры для просмотра без звука.
Вертикальный аватар для TikTok и Reels
Шаблон уже рендерит в 9:16. Оставьте воздух над головой под экранный текст и срежьте первые полсекунды на монтаже: видеомодели часто стартуют со слегка застывшего кадра.
Частые ошибки
Слишком длинный текст на восемь секунд
В один дубль укладываются две короткие фразы. Дальше модель разгоняет темп речи или обрывает концовку, и ради одного слова приходится оплачивать весь рендер заново.
Описывать голос после запуска рендера
Голос выходит из того же рендера, что и картинка: тембр, темп и интонация описываются в промпте до генерации. Смена голоса означает новый дубль.
Слишком крупный план лица
На тесной крупности вылезают микродефекты вокруг рта. Поясной план с лёгким смещением от центра оставляет место жестам и делает дубль убедительнее.
Вы описываете его в промпте, как кастинговую заявку: тембр, темп, намерение. Из списка он не выбирается, и два рендера одного текста могут слегка отличаться.
Говорит ли модель по-русски?
Да. Напишите реплику по-русски в кавычках внутри промпта, остальная часть описания может оставаться на английском, на язык речи это не влияет.
Что делать, если дубль не получился?
Перезапустить. Восьмисекундный дубль стоит несколько десятков центов кредитами, а нода хранит историю предыдущих рендеров: при сравнении двух версий ничего не теряется.
Насколько точно совпадают губы и речь?
Совпадают, потому что изображение и речь выходят из одного рендера: ничего не склеивается постфактум. Этим workflow и отличается от классических цепочек, где расхождения в десятую долю секунды хватает, чтобы выдать монтаж.
Можно ли поставить собственное лицо?
Да, заполнив карточку Референс тремя своими фотографиями. Делайте это только с лицом человека, который дал согласие: спикер, собранный из чужих фотографий, это реальная проблема с правом на изображение.
Во сколько обходится восьмисекундный дубль?
Примерно в 144 кредита на Veo 3.1 Fast, то есть около полутора евро вместе с исходным кадром. Точная сумма появляется на кнопке до запуска рендера.
Можно ли собрать несколько реплик подряд?
Да, по одной ноде Видео на реплику, все подключены к той же карточке лица и тому же исходному кадру. Склейка встык даёт минутное видео с неизменным ведущим.
 Veo 3.1 Fast
 HeyGen Video 1
 Seedream 5 Pro
 Kling V3