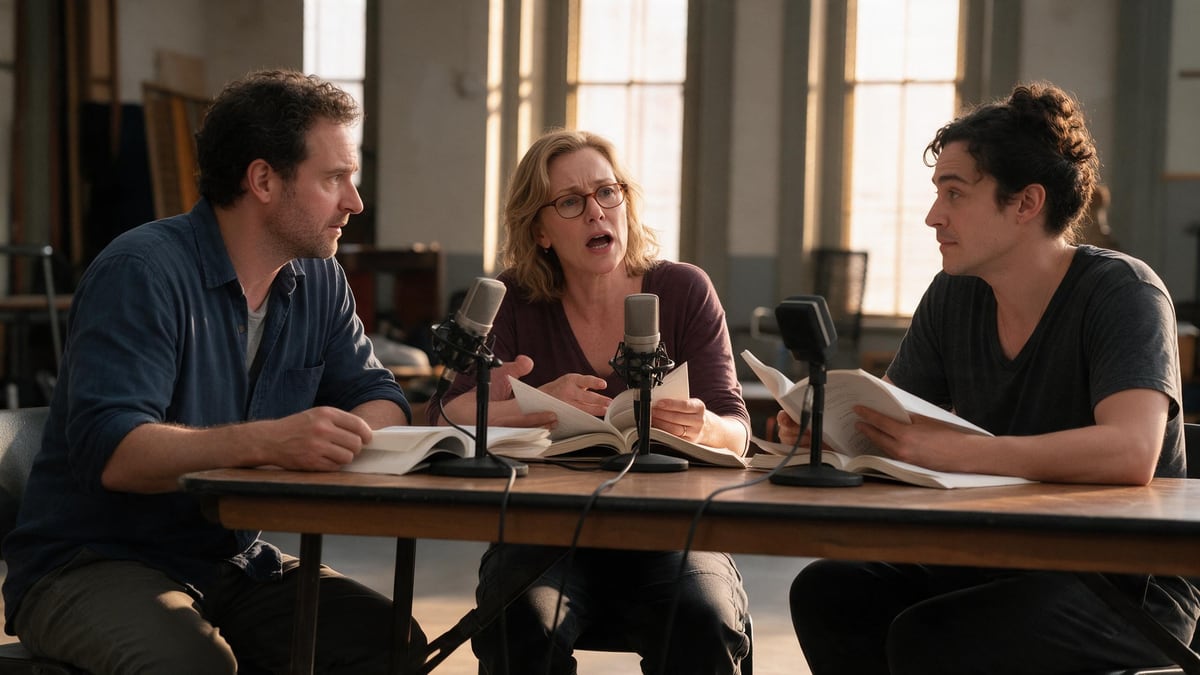
הקראת סצנת דיאלוג
זו ההדגמה: עשר שורות, שתי דמויות וקריין, טייק אחד. לסצנה ארוכה יותר, שני nodes של Voice-over של עשר שורות כל אחד, מחוברים בזה אחר זה ב-node של Montage.
התסריט בפורמט PDF שגורר אל הקנבס: node של Text שמפיק ממנו עשר שורות מוכנות להקראה, קריין לפעולה ודמויות מילה במילה, ו-node של Voice-over במצב דיאלוג שמנגן אותן בטייק אחד עם שלושה קולות של ElevenLabs. ההקראה שעושים עם שחקנים, בשלושה קליקים. כל התהליך נראה לעין בלי צורך בחשבון.
התהליך האמיתי: התסריט המקורי בן שלוש הסצנות בפורמט PDF בתוך node של Media, Claude Sonnet 5 לעשר השורות, node של Voice-over במצב דיאלוג על ElevenLabs Dialogue v3 עם שלושה קולות. הטקסטים המוצגים הם תשובות המודלים, בלי שום עריכה.
בקצרה
דיאלוג נבדק רק באוזן. ה-PDF של התסריט נכנס ל-node של Media, ו-node של Text קורא אותו דרך הפורט "תמונה או PDF לניתוח" כדי להפיק ממנו עשר שורות בפורמט שם: טקסט: קריין שאומר את הפעולה המרכזית במשפט אחד, והדמויות מילה במילה, כמו בתסריט המקורי.
ה-node של Voice-over במצב דיאלוג נושא את עשר השורות הללו, כל אחת עם הקול שלה, ו-ElevenLabs Dialogue v3 מנגן אותן במעבר אחד: הקצב, השתיקות, החזרות מגיעים מהמודל, לא מעריכה. שלושה קולות בהדגמה: קריין עמוק, קול של אישה בוגרת בשביל Maren, קול של גבר צעיר בשביל Elias.
ההדגמה מקריאה את סצנות 2 ו-3 מתוך "North of Silence", התסריט המקורי של התבנית תסריט לסרט. עשר שורות ל-node: לסצנה הבאה, יש לשכפל את ה-node של Voice-over ולהדביק בו את עשר השורות הבאות, שנכתבו על ידי ה-node של Text. יש להחליף את ה-PDF בתסריט שלך ואת השמות בהוראה.
אלה הקבצים של ה-workflow שמעל, כפי שהמודלים הפיקו אותם, בלי עיבוד נוסף. נקודת הפתיחה מוצגת כשיש כזו.
תוצר
תסריטאים, מחזאים וכותבי בדיון שרוצים לשמוע דיאלוג לפני עיבוד מחדש או לפני שהוא נקרא על ידי שחקנים.
תסריט או פרק בפורמט PDF טקסטואלי: שמות באותיות גדולות ותיאורי מיקום עוזרים להפריד בין הפעולה לשורות.
גרור את התסריט בפורמט PDF
node של Media מקבל אותו. מומלץ פורמט תסריט קלאסי: שמות באותיות גדולות ותיאורי מיקום עוזרים למודל להפריד בין הפעולה לשורות.
תן ל-node של Text לכתוב את השורות
עשר שורות בפורמט שם: טקסט, כשמציינים בהוראה את הסצנות להקראה ואת שמות הדמויות שלך. NARRATOR מסכם את הפעולה, והדמויות מדברות מילה במילה.
הדבק את השורות ב-node של Voice-over
ל-node של Voice-over במצב דיאלוג יש שורות משלו: שורה אחת לכל דיבור, קול אחד לכל דמות שנבחר מהרשימה. עשר שורות ל-node; node שני לסצנה הבאה.
הקשב, ואז דייק
טייק אחד מנגן את כל החלופה. שורה שנשמעת שטוחה: הוסף תג משחק, [sighs] או [whispers], בתוך הטקסט. קול שלא מתאים: החלף אותו בשורה, לא בכל ה-node.
אותו קנבס, מכוון לצרכים שונים: כל וריאציה מסתכמת בשתיים-שלוש שורות פרומפט להחלפה.
זו ההדגמה: עשר שורות, שתי דמויות וקריין, טייק אחד. לסצנה ארוכה יותר, שני nodes של Voice-over של עשר שורות כל אחד, מחוברים בזה אחר זה ב-node של Montage.
פרק מרומן בפורמט PDF עובד גם הוא: הקריין קורא את הפרוזה, והדמויות את הדיאלוגים במרכאות. יש לבקש מה-node של Text לשמור על המשפטים המדויקים.
בלוני הדיבור של עמוד, אחד לכל שורה עם שם הדמות: ה-node של Voice-over מנגן את העמוד, ו-node של Montage מציב אותו על המסך עם הקול.
שכפל את ה-node של Voice-over והחלף רק את הקול של דמות אחת בכל עותק: שלושה טייקים, שלושה גוונים, וההשוואה נעשית באוזן בתוך דקה.
בקש מה-node של Text לתרגם את השורות והגדר את שפת ה-node של Voice-over: ElevenLabs Dialogue מנגן ארבע-עשרה שפות, עם אותם קולות.
מצב הדיאלוג לוקח עשר שורות לטייק. סצנה של שלושים שורות היא שלושה nodes של Voice-over, מחוברים ב-node של Montage עם חצי שנייה של שתיקה בין הטייקים.
שני גוונים דומים נשמעים כמו מונולוג. יש לבחור קול עמוק וקול בהיר, או אישה וגבר, לפני חיפוש דקויות עדינות יותר.
הקריין צריך לומר את הפעולה במשפט אחד, לא את ההערות בסוגריים של התסריט. ההוראה של ה-node של Text מבקשת זאת: יש לבדוק את עשר השורות לפני ההדבקה.
מפני שמצב הדיאלוג נושא את שורותיו עם קול אחד לכל אחת, עד עשר לכל טייק: זה מה שהמודל מנגן במעבר אחד. ה-node של Text מכין אותן בפורמט הנכון, וההדבקה לוקחת עשר שניות.
כעשרים גוונים של ElevenLabs, כמספר הדמויות בעשר השורות. שלושה בהדגמה: קריין, Maren, Elias. קולות בגוונים מנוגדים נשמעים טוב יותר ממונולוג.
כעשרה קרדיטים לעשר שורות: קריאת ה-PDF על ידי Claude Sonnet 5 והדיאלוג של ElevenLabs, בחיוב לפי תו. המחיר מוצג על ה-node לפני הלחיצה.
כן: קול שהוקלט ושוכפל מהספרייה שלך נבחר בשורה כמו כל גוון אחר. יש לשכפל את הקול קודם ב-node של Voice-over, ואז להקצות אותו לדמות.
המודל ממקם את הנשימות בעצמו. לשתיקה אמיתית, יש לחלק את ההקראה לשני nodes ולהשאיר שנייה ביניהם ב-Montage.
שפת השורות, שנקבעת ב-node של Voice-over: אנגלית בהדגמה, ארבע-עשרה שפות זמינות. תסריט בעברית נקרא בעברית, עם אותם קולות.
כן: node של Montage עם העטיפה או תמונה של הסצנה כקליפ, ההקראה על פס הסאונד, מייצא mp4 לרשתות חברתיות או תיקיית הפקה.
לגרום לתסריט להיקרא בכמה קולות בעזרת AI
שימוש ב-workflow הזהחשבון חינמי, בלי כרטיס אשראי. ה-workflow נפתח מוכן מראש בקנבס שלכם.
 ElevenLabs Dialogue v3
 Claude Sonnet 5
 Grok TTS