O trecho do primeiro capítulo
Esta é a demonstração: a abertura reproduzida palavra por palavra, uma voz de narrador, uma camada, a capa na tela. Substitua o PDF e o título, mantenha o resto, e o vídeo se refaz para o seu livro.
O capítulo em PDF solto no canvas: um node Texto reproduz a abertura palavra por palavra, uma voz de narrador ElevenLabs a lê, uma camada instrumental toca por baixo, e a capa permanece na tela em um Montagem 16:9: o vídeo pronto para publicar e fazer as pessoas ouvirem o primeiro capítulo. O fluxo de trabalho inteiro é visível sem conta.
 Demo interativa
Workflow real, resultados reais. Desloque-se e faça zoom livremente.
Usar este workflowO fluxo de trabalho real: o primeiro capítulo de um romance em PDF em um node Mídia, Claude Sonnet 5 reproduzindo a abertura, ElevenLabs v3 para a narração, ElevenLabs Music para a camada, GPT Image 2.5 Flare para a capa, um node Montagem. Os textos exibidos são as respostas dos modelos, sem retoque.
Em resumo
Fazer as pessoas ouvirem o primeiro capítulo é a melhor propaganda de um livro. O PDF entra em um node Mídia, e um node Texto o lê pela porta "Imagem ou PDF a analisar" para reproduzir a abertura palavra por palavra, sem reescrever nada, até o fim de um parágrafo antes de 1.400 caracteres: a duração de uma leitura de um minuto e meio.
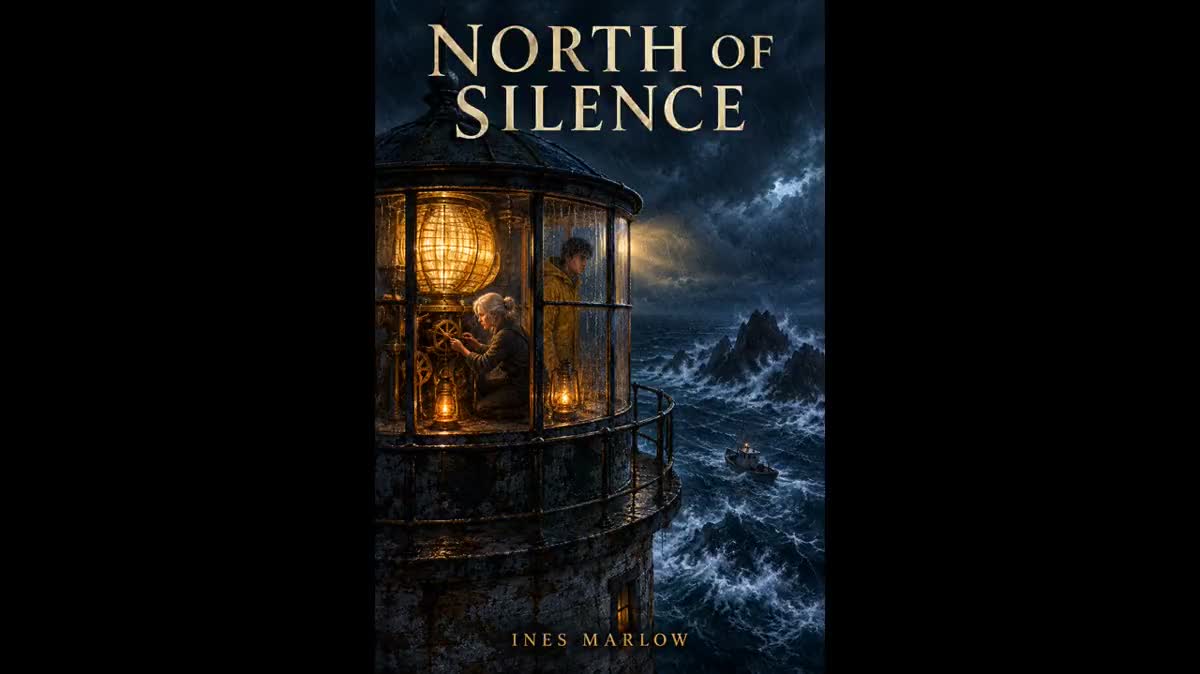
O node Voz-off lê esse texto conectado com ElevenLabs v3, uma voz de narrador escolhida na lista. O node Música compõe sessenta segundos de camada instrumental a partir de um briefing conectado, em loop no Montagem em volume baixo. O node Imagem desenha a capa com o título usando GPT Image 2.5 Flare, e o Montagem a mantém inteira, sobre fundo preto, durante toda a narração.
A demonstração lê a abertura de "North of Silence", um romance original escrito para o exemplo. Substitua o PDF pelo seu capítulo, a voz no node, o título no prompt da capa. Um capítulo inteiro se lê em vários nodes Voz-off de 3.000 caracteres, colocados lado a lado no Montagem. A capa e o trailer completam a série.
Estes são os arquivos do workflow acima, exatamente como os modelos os produziram, sem retoques. O ponto de partida é indicado quando existe um.
Resultado
Autores e editores que querem fazer as pessoas ouvirem um primeiro capítulo sem estúdio nem ator, ou testar uma voz antes de um livro em áudio completo.
Um capítulo em PDF de texto, não um escaneado: o node Texto reproduz a prosa tal como está e a voz a lê frase por frase.
Solte o capítulo em PDF
Um node Mídia o recebe. O node Texto reproduz a abertura, não um resumo: é a sua prosa que é lida, frase por frase, até o fim de um parágrafo.
Escolha a voz e leia
O node Voz-off recebe o texto por cabo. Cerca de vinte timbres ElevenLabs v3, ou uma voz clonada: a demonstração usa George, um narrador sereno. Uma tag [pause] ou [whispers] no texto guia a interpretação.
Componha a camada e desenhe a capa
O node Música compõe sessenta segundos a partir do briefing conectado, instrumental. O node Imagem escreve o título na capa em 3:4, dois créditos. Os dois podem ser refeitos sem mexer na narração.
Monte e publique
O Montagem coloca a capa inteira sobre fundo preto em 16:9, a narração em uma faixa, a camada em loop em volume baixo na outra, com um fade final. Renderizado no navegador, sem créditos, exportado em mp4.
O mesmo canvas, afinado para necessidades diferentes: cada variante são duas ou três linhas de prompt a mudar.
Esta é a demonstração: a abertura reproduzida palavra por palavra, uma voz de narrador, uma camada, a capa na tela. Substitua o PDF e o título, mantenha o resto, e o vídeo se refaz para o seu livro.
Um node Texto por trecho de 3.000 caracteres, um node Voz-off para cada um, todos no mesmo Montagem: um capítulo de quinze minutos se lê em cerca de dez nodes, com a camada em loop por baixo.
Clone sua voz em um node Voz-off a partir de um minuto de gravação, depois escolha-a para a narração: o primeiro capítulo é lido por você, sem estúdio.
Remova o node Imagem e o Montagem: a narração e a camada se exportam em mp3 a partir dos nodes, para uma plataforma de podcast ou a página do livro.
Peça ao node Texto para traduzir o trecho, ajuste o idioma do node Voz-off, mantenha a capa: o mesmo vídeo existe em inglês, espanhol, alemão, com a mesma voz.
A instrução diz para reproduzir a prosa exatamente. Se o modelo resume, é porque leu um PDF escaneado sem texto: converta o manuscrito em PDF de texto, não em imagens de páginas.
A música está em 0,25 no Montagem para permanecer abaixo da narração. Uma camada com uma melodia marcante atrai o ouvido: peça ao briefing um fundo sem tema, sem percussão.
O Montagem está ajustado para conter a imagem inteira sobre fundo preto. No modo cobrir, uma capa em 3:4 perde o título em cima e embaixo: mantenha contido para um trecho.
Sim, em partes: um node Voz-off lê até 3.000 caracteres. Peça ao node Texto a parte seguinte, duplique o node Voz-off e coloque as partes lado a lado no Montagem. O preço acompanha os caracteres lidos.
Cerca de sessenta créditos para a demonstração: a narração de 1.400 caracteres (cerca de doze créditos), a camada de sessenta segundos (cerca de cinquenta), a capa (dois) e a leitura do PDF (dois a três). O preço aparece em cada node antes de você clicar.
Sim: o ElevenLabs v3 marca vírgulas, pontos finais e parágrafos separados por uma linha em branco. Para uma pausa mais longa, a tag [pause]; para um sussurro, [whispers]. As tags não são lidas em voz alta.
De um minuto e meio a dois minutos, ou seja, 1.400 a 1.800 caracteres: o suficiente para estabelecer uma voz e uma cena, curto o bastante para ser ouvido por inteiro em um telefone.
Sim, no node Voz-off, sem regenerar o texto: escolha outro timbre e execute a leitura novamente, o Montagem se atualiza.
Não, qualquer clipe de imagem serve para o Montagem: uma foto do autor, uma ilustração do lugar. A capa com o título continua sendo o que mais se compartilha.
Na página do livro, nas redes sociais, como episódio zero de um podcast: o mp4 sai em 16:9, 1080p, com o som mixado. Um Montagem em 9:16 faz a versão vertical.
Criar o trecho em áudio de um livro com IA
Usar este workflowConta gratuita, sem cartão. O workflow abre-se pré-preenchido no seu canvas.
 ElevenLabs v3
 Claude Sonnet 5
 GPT Image 2.5 Flare