La reunión de lanzamiento
Un brief de producto se convierte en tres diapositivas para el equipo esa misma mañana, sin pasar una hora en un programa de presentaciones alineando columnas que no quieren alinearse.
Su brief en PDF pasa a dos nodes Texto que escriben cada uno una diapositiva, y GPT Image 2.5 Sunburst las dibuja en 16:9, texto incluido. Workflow visible aquí, sin cuenta.
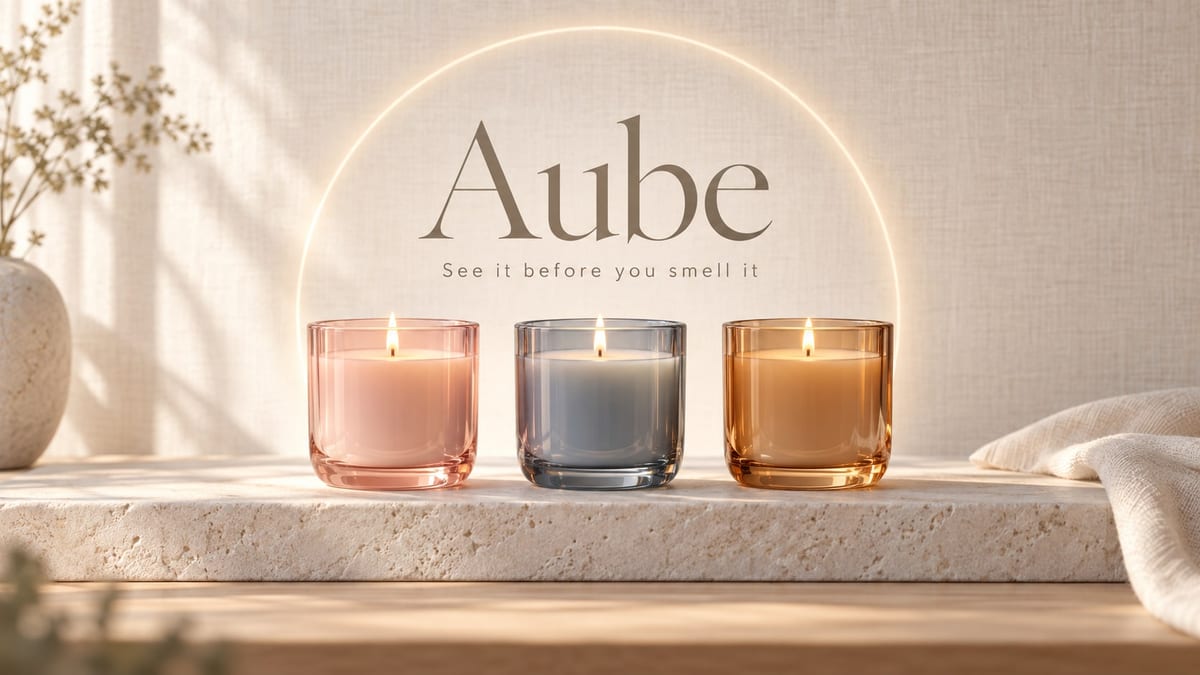
Workflow real: el brief de lanzamiento de una marca de velas, leído por dos nodes Claude Sonnet 5 que escriben las consignas, dos diapositivas dibujadas por GPT Image 2.5 Sunburst. Ambas imágenes vienen de la demo.
En resumen
Una presentación casi nunca se atasca en las ideas: se atasca en la maquetación, la paleta, las columnas que no quieren alinearse. Este workflow toma el documento que usted ya tiene, un brief, una nota, un informe, y saca de él diapositivas dibujadas, título y cifras incluidos.
Lo difícil se resume en tres palabras: texto dentro de la imagen. Un modelo de imagen escribe correctamente una decena de palabras, y más allá inventa letras. Por eso las dos consignas de la demo dan las palabras EXACTAS a escribir entre comillas y prohíben todo lo demás, lo que de paso produce diapositivas más legibles que la media.
Los dos nodes Texto leen el PDF ellos mismos, lo que significa que se puede cambiar de documento sin retocar una consigna. Una pasada completa cuesta menos de treinta créditos, y la maquetación de un currículum responde a la misma mecánica para una sola página.
Estos son los archivos del flujo de trabajo anterior, tal como los produjeron los modelos, sin retoques. El punto de partida se indica cuando existe.
Resultado
Jefes de producto, autónomos y docentes que ya tienen el documento y no quieren pasar la tarde alineando columnas.
Un PDF de texto de una a diez páginas, exportado desde un procesador de texto: un escaneo no se puede leer, el node Texto solo vería píxeles.
Suelte su documento
Un PDF de texto, no un escaneo: el node Texto lee el contenido, no los píxeles. Un brief, una nota de encuadre o un informe de tres páginas funcionan perfectamente.
Deje que el node Texto escriba la consigna
No resume el documento, escribe la consigna de imagen de UNA diapositiva: las palabras exactas a escribir, la maquetación, la paleta, la tipografía.
Imponga el poco texto
Las palabras exactas entre comillas, y la prohibición de escribir cualquier otra cosa. Es la regla que separa una diapositiva limpia de una imagen llena de palabras falsas.
Relea las cifras
Un modelo de imagen puede desplazar un decimal. Una lectura de diez segundos antes de proyectar evita el único error que nadie perdona en una reunión.
El mismo canvas, ajustado a necesidades distintas: cada variante son dos o tres líneas de prompt que cambiar.
Un brief de producto se convierte en tres diapositivas para el equipo esa misma mañana, sin pasar una hora en un programa de presentaciones alineando columnas que no quieren alinearse.
Un informe de veinte páginas que nadie leerá da tres pantallas que todo el mundo mirará: el título, las cifras, la conclusión. El documento sigue siendo la fuente, no se reescribe.
Tres números y tres etiquetas caben en una imagen, y es exactamente lo que un modelo de imagen sabe escribir con nitidez. Es la diapositiva más útil del conjunto, y la más segura.
Un título 16:9 bien dibujado también sirve de pantalla de apertura en un montaje, ahí donde una captura de un programa de presentaciones se nota enseguida.
Un capítulo de curso da una diapositiva por concepto, con las palabras clave escritas en grande. Para un material completo, el libro ilustrado muestra la misma mecánica en una serie de páginas.
La paleta y la tipografía están en la consigna, así que no varían de una diapositiva a otra: dos nodes, una sola identidad, tantas imágenes como se quiera.
Es el error que lo estropea todo. Más allá de una decena de palabras, el modelo de imagen escribe letras que no existen. Las palabras exactas entre comillas, y nada más: la restricción también da mejores diapositivas.
Un PDF escaneado es una imagen: el node Texto no lee nada en él e inventa una presentación plausible de la nada. Un PDF de texto, exportado desde un procesador de texto, lo cambia todo.
Sin colores impuestos, cada diapositiva va por su lado y el conjunto se desmorona. La paleta se pone en la consigna, una vez, y se copia de un node a otro.
Un modelo de imagen redibuja las cifras en lugar de copiarlas, y un decimal puede moverse. Es la única verificación obligatoria antes de proyectar.
No, la salida es una imagen por diapositiva, en 16:9. Es perfecto para proyectar, publicar o insertar en un documento, y no se modifica texto por texto como un archivo de ofimática.
Duplique el par de nodes tantas veces como necesite: cada diapositiva es un node Texto y un node Imagen. La demo muestra dos para seguir siendo legible, la mecánica no cambia en la décima.
El node Texto toma los números de su PDF, pero el node Imagen los redibuja, y ahí es donde el decimal puede moverse. Releer las cifras en pantalla es la única verificación que importa.
Veinticuatro créditos para las dos diapositivas de la demo: tres créditos por lectura del PDF, nueve créditos por imagen en calidad alta. Una diapositiva más es aproximadamente una docena de créditos.
GPT Image 2.5 Sunburst en una diapositiva clara, medido limpio letra por letra. Sobre un fondo plano muy oscuro, devolvió manchas negras tres veces el 18 de septiembre de 2026: Nano Banana Pro aguanta mejor esos fondos.
Sí, escribiéndola en la consigna: los códigos de color, la familia de tipografía, la ubicación del título. El node Texto la aplicará en cada diapositiva ya que lee la misma instrucción.
Se envía al modelo que lo lee, como cualquier archivo adjunto enviado a una IA, y nada se publica. Para un documento sensible, haga la prueba con una versión anonimizada.
Sí, la consigna decide el idioma escrito en la imagen. Pida las palabras exactas en el idioma deseado y el modelo las escribe tal cual.
Crear una presentación con IA, a partir de un PDF
Usar este workflowCuenta gratuita, sin tarjeta bancaria. El workflow se abre ya rellenado en tu canvas.
 GPT Image 2.5 Sunburst
 Claude Sonnet 5
 Nano Banana Pro