הפרסומת בחמש שפות
פרסומת שצולמה בצרפתית הופכת לחמישה קבצים: נוד Voice-over אחד לכל שפה, נוד Sync Lipsync 3 אחד לכל שפה, אותו וידאו בכניסה. התקציב נראה על כל כפתור לפני ההפעלה.
וידאו שבו מישהו מדבר, קול חדש בשפה אחרת: Sync Lipsync 3 מסנכרן מחדש את השפתיים לטקסט החדש. אותו צילום באנגלית ובספרדית, בלי לצלם מחדש. תהליך העבודה כולו נראה לעיניים בלי חשבון.
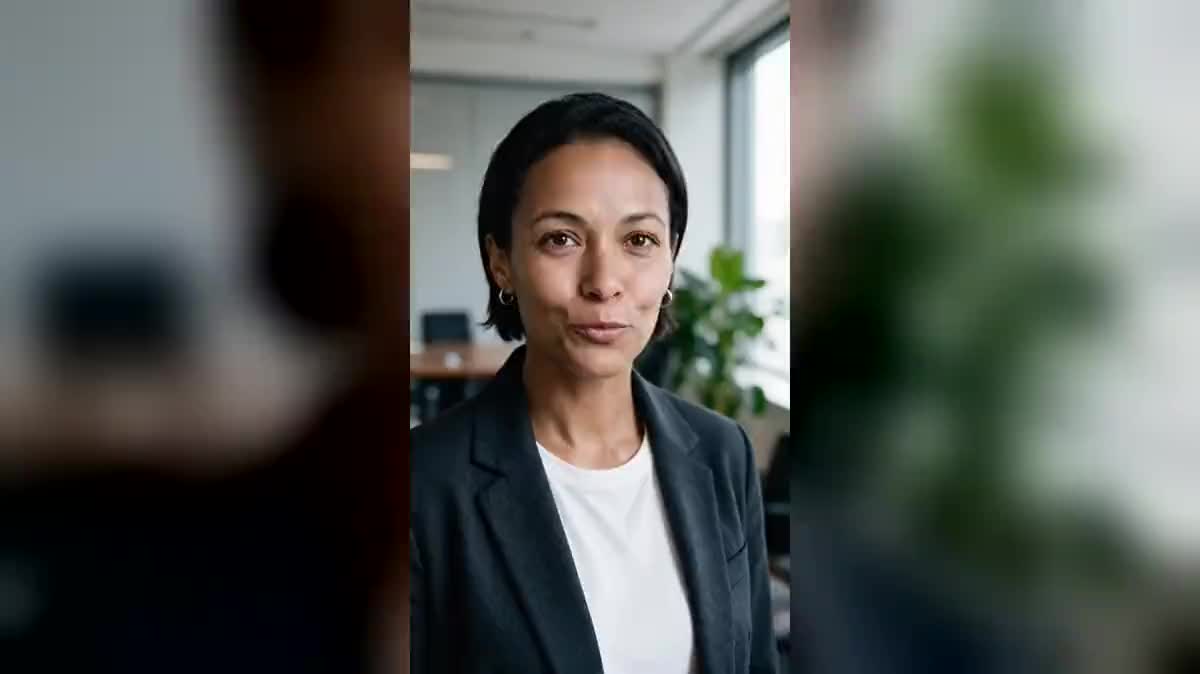
תהליך העבודה בפועל: הווידאו של האווטאר בנוד Media, שני תרגומים שכל אחד מהם מוקרא על ידי נוד Voice-over, ושני נודים מסוג Video מוגדרים ל-Sync Lipsync 3 שמקבלים את הווידאו בפורט הווידאו ואת הקול בפורט הקול.
בקצרה
וידאו שצולם פעם אחת, ומופק בכל השפות הדרושות: זה מה שדיבוב עם סנכרון שפתיים עושה. האדם על המסך לא אומר יותר את המשפט המקורי, הוא אומר את התרגום, והפה שלו עוקב אחרי הקול החדש פריים אחר פריים. הפנים, התאורה והמסגור נשארים כמו בצילום המקורי.
הטקסט המתורגם מוקרא בנוד Voice-over, עם קול מהקטלוג או קול מוקלן, שלכם לדוגמה. נוד ה-Video המוגדר ל-Sync Lipsync 3 מקבל את הווידאו ואת הקול, ומרנדר את הצילום המדובב. המחיר עוקב אחרי משך הזמן שהופק, נמדד על שני הקבצים שלכם, ומוצג לפני שלוחצים.
ההדגמה מתחילה מהווידאו של האווטאר המדבר, בצרפתית, ומפיקה אותו באנגלית ואז בספרדית. פרסומת, וידאו הכשרה פנימי, מצגת מוצר: צילום אחד, קובץ אחד לכל שוק.
אלה הקבצים של ה-workflow שמעל, כפי שהמודלים הפיקו אותם, בלי עיבוד נוסף. נקודת הפתיחה מוצגת כשיש כזו.
נקודת פתיחה
תוצר
קובץ mp4 שבו אדם אחד מדבר מול המצלמה, הפה גלוי מתחילת הסרטון ועד סופו, סאונד נקי.
טעינת הווידאו המדובר
פרצוף מצולם מהחזית, מוארת היטב, פה גלוי, בלי יד או מיקרופון מלפניו. עד שתי דקות למעבר. צילום שצולם בטלפון מתאים.
כתיבת התרגום ובחירת הקול
כל נוד Voice-over מקריא טקסט בשפה אחת. בחרו קול הקרוב לדמות, או שכפלו את הקול שלה כדי לשמור על הצליל שלה משפה לשפה.
הגדרת ההתאמה בין משכי הזמן
כברירת מחדל, התוצאה מפסיקה בקצר משני משכי הזמן. אם הקול חורג מהצילום, בחרו ב"לופ": הווידאו חוזר על עצמו מתחת לקול, מה שעובד היטב בשוט ישיר למצלמה.
יצירה והשוואה
נוד אחד לכל שפה, כולם מחוברים לאותו הווידאו. המחיר של כל אחד עוקב אחרי משך הזמן שלו. הריצו מחדש רק את השפה שלא אהבתם.
אותו קנבס, מכוון לצרכים שונים: כל וריאציה מסתכמת בשתיים-שלוש שורות פרומפט להחלפה.
פרסומת שצולמה בצרפתית הופכת לחמישה קבצים: נוד Voice-over אחד לכל שפה, נוד Sync Lipsync 3 אחד לכל שפה, אותו וידאו בכניסה. התקציב נראה על כל כפתור לפני ההפעלה.
מדריך מצולם ישירות למצלמה, הטקסט מתורגם על ידי נוד Text, מוקרא על ידי נוד Voice-over, והווידאו מדובב לצוותים בחוץ לארץ. העריכה נשארת אותה.
דיבוב משמש גם באותה שפה: משפט שנאמר בטעות, מחיר שהשתנה, שם לתיקון. שכתבו את הטקסט, הריצו מחדש, הפה עוקב.
עדות אמינה זוכה בקהל זר בלי לאבד את פני האדם: דבבו אותה בקול קרוב, ושמרו על הכתוביות לצורך נגישות.
התחילו מוידאו שהופק על ידי האווטאר המדבר או על ידי פרסומת UGC, ודבבו אותו: הדמות המסונתטת מדברת בכל שפה בלי להפיק מחדש את הצילום.
אם אין לכם וידאו התחלתי, הפכו תמונה לדוברת: InfiniTalk מייצר את תנועת הפנים מפורטרט וקול.
המודל מסנכרן פרצוף אחד. עם שני אנשים על המסך, התוצאה לא צפויה. מסגרו את זה שמדבר.
במצב חתך, התוצאה מפסיקה עם הווידאו וסוף הטקסט נעלם. קצרו את התרגום או עברו למצב לופ.
יד, מיקרופון, כוס: כל דבר שעובר מלפני הפה שובר את הסנכרון בפריימים האלה. השאירו את הפנים פתוחות בצילום.
התוצאה מכילה רק את הקול. החזירו את המוזיקה לנוד Montage, אחרת הגרסה המדובבת נשמעת חשופה יותר מהמקור.
הוא יכול
הוא לא יכול
לא: זו כל הנקודה. וידאו אחד, נוד Voice-over אחד לכל שפה, והשפתיים עוקבות אחרי כל תרגום.
לא, רצועת השמע של התוצאה היא הקול המחובר. כדי לשמור על מוזיקה או אווירה, החזירו אותם לנוד Montage מעל הווידאו המדובב.
כן: שכפלו את קולכם בנוד Voice-over, כתבו את התרגום, והקול המשוכפל מקריא אותו. השפתיים עוקבות.
משנייה אחת עד שתי דקות למעבר. מעבר לזה, חתכו את הווידאו בנוד Montage ודבבו את החלקים.
המחיר עוקב אחרי משך הזמן שהופק, לשנייה, ומוצג על הכפתור מהרגע שהווידאו והקול מחוברים. כשל טכני מוחזר באופן אוטומטי.
כן, בדיוק כמו על צילום אמיתי. צילום מ-Wan, Seedance או Veo עם פנים מהחזית מדובב כמו כל וידאו אחר.
כן: רק הפה מחושב מחדש. הידיים, הגבות, תנועות הראש הן אלו של הצילום המקורי.
קול באותו רגיסטר של האדם, או השכפול שלו. הקשיבו לקול בלבד בנוד Voice-over לפני הפעלת הסנכרון.
דיבוב וידאו עם AI, שפתיים בסנכרון
שימוש ב-workflow הזהחשבון חינמי, בלי כרטיס אשראי. ה-workflow נפתח מוכן מראש בקנבס שלכם.
 Sync Lipsync 3
 ElevenLabs v3
 InfiniTalk
 Veo 3.1 Fast