एक सिंथेटिक प्रेज़ेंटर आपकी स्क्रिप्ट कैमरे की तरफ़ बोलता है, अपनी आवाज़ में। Veo 3.1 इमेज और आवाज़ एक साथ बनाता है, इसलिए होंठ सही बैठते हैं। वर्कफ़्लो यहीं दिख रहा है, बिना अकाउंट के।
इंटरैक्टिव डेमो
असली वर्कफ़्लो, असली नतीजे। खुलकर घुमाइए और ज़ूम कीजिए।
रेफ़रेंस शीट चेहरा थामती है, टेक्स्ट नोड स्क्रिप्ट रखता है, और वीडियो नोड आठ सेकंड आवाज़ के साथ रेंडर करता है। कोई वॉइस ओवर नोड नहीं: बोली वीडियो मॉडल से ही निकलती है। प्रॉम्प्ट पढ़ने के लिए नोड खोलिए।
एक नज़र में
आप जो देते हैं
1 संदर्भ शीट (फ़ोटो और विवरण) · एक टेक्स्ट या ब्रीफ़
यह वर्कफ़्लो क्या बनाता है
9:16 में 1 इमेज · 720p में 8 सेकंड की 1 वीडियो, फ़ॉर्मैट 9:16
कैनवास की बनावट
2 कनेक्शन से जुड़े 5 नोड
जुड़े हुए मॉडल
Seedream 5 Pro, Veo 3.1 Fast
एक पूरे राउंड का ख़र्च
लगभग 149 क्रेडिट, यानी $1.79
अकाउंट
डेमो बिना अकाउंट के भी देखा जा सकता है; जनरेट करने के लिए एक मुफ़्त अकाउंट चाहिए, जिसमें ट्रायल क्रेडिट शामिल हैं
बोलता हुआ अवतार हमेशा एक ही दीवार से टकराता है: लिप सिंक। पुराने तरीक़े बिना आवाज़ का वीडियो बनाते हैं, आवाज़ अलग से तैयार करते हैं, फिर दोनों को जोड़ने की कोशिश करते हैं, और वह दसवें हिस्से भर सेकंड का फ़र्क़ बचा रह जाता है जो तुरंत नक़ली लगता है।
यहाँ आवाज़ और इमेज एक ही रेंडर से निकलती हैं। Veo 3.1 Fast डायलॉग को वीडियो के साथ बनाता है: होंठ आवाज़ के साथ चलते हैं क्योंकि दोनों साथ कैलकुलेट हुए हैं। बदले में एक शब्द बदलने का मतलब है पूरा रेंडर दोबारा, इसलिए स्क्रिप्ट चलाने से पहले पक्की कर ली जाती है, और इसीलिए वह अपने अलग टेक्स्ट नोड में रहती है, जिसे किरदार छुए बिना बदला जा सकता है।
चेहरा तीन एंगल वाली रेफ़रेंस शीट थामती है, वही मैकेनिक्स जो कई शॉट में किरदार को एक जैसा रखने में काम आती है। इस तरह आप एक ही प्रेज़ेंटर के साथ पूरी सीरीज़ बना लेते हैं, एपिसोड दर एपिसोड। Seedream 5 Pro शुरुआती शॉट कंपोज़ करता है, और पब्लिक कैलकुलेटर साइन अप से पहले एक टेक की सटीक लागत बता देता है।
डेमो के वास्तविक रेंडर
ये ऊपर वाले वर्कफ़्लो की फ़ाइलें हैं, ठीक वैसी ही जैसी मॉडलों ने बनाई, बिना किसी सुधार के। जहाँ शुरुआती बिंदु मौजूद है, वहाँ उसे दिखाया गया है।
शुरुआती बिंदु
प्रेज़ेंटरप्रेज़ेंटरप्रेज़ेंटर
रेंडर
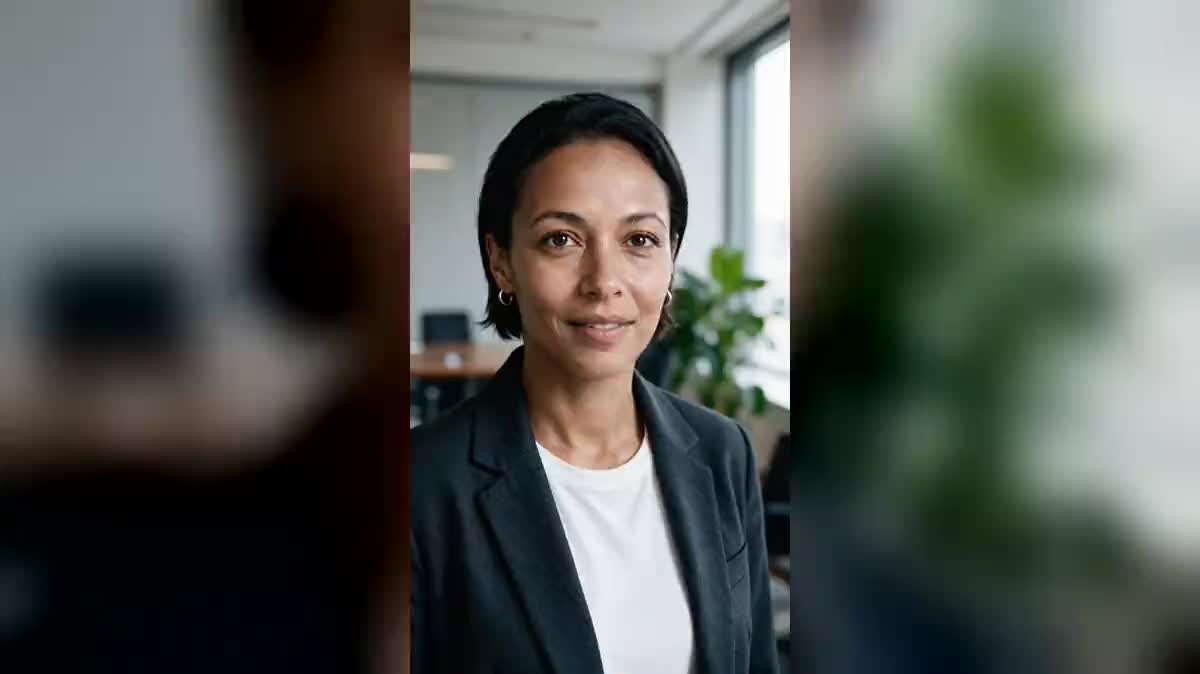
शुरुआती जनरेटेड फ्रेम: प्रेजेंटर को सीने तक फ्रेम में दिखाया गया है, एक रोशन ऑफिस मेंSeedream 5 Pro से जनरेट किया गयावीडियो: वह कैमरे की तरफ देखकर स्क्रिप्ट बोलती है, आवाज़ वीडियो के अंदर ही जनरेट की गई हैVeo 3.1 Fast से जनरेट किया गया
कैसे करें
1
प्रेज़ेंटर बनाइए
रेफ़रेंस शीट में चेहरे के तीन व्यू रखिए। इसी की वजह से अगले एपिसोड में, दूसरे सेट और दूसरे टेक्स्ट के साथ, बिलकुल वही इंसान वापस मिलता है।
2
शॉट कंपोज़ कीजिए
इमेज नोड सीन को फ़्रेम करता है: डेस्क, लाइट, स्क्रीन पर टेक्स्ट के लिए छोड़ी गई जगह। छाती तक का शॉट, हल्का सा एक तरफ़, हाथों के इशारों के लिए जगह छोड़ता है।
3
डायलॉग लिखिए
टेक्स्ट नोड में सीन का निर्देश और बोली जाने वाली लाइन, कोट्स के अंदर, रहती है। आठ सेकंड के लिए दो छोटे वाक्य काफ़ी हैं, और टोन को एक्टिंग के निर्देश की तरह लिखा जाता है।
4
टेक रेंडर कीजिए
आठ सेकंड, वर्टिकल फ़ॉर्मैट, ऑडियो ऑन। आवाज़ वीडियो फ़ाइल में ही आती है: बाद में कुछ सिंक करना नहीं पड़ता, और टेक अच्छी हो तो एडिट भी नहीं।
वेरिएंट और इस्तेमाल के तरीके
वही कैनवास, अलग-अलग ज़रूरतों के लिए सेट किया हुआ: हर वेरिएंट में प्रॉम्प्ट की बस दो-तीन लाइनें बदलनी होती हैं।
ट्रेनिंग कोर्स के लिए प्रेज़ेंटर अवतार
ट्रेनिंग मॉड्यूल आठ सेकंड के हिस्सों में बँटता है, हर हिस्सा अपने वीडियो नोड में, और सब एक ही चेहरे वाली शीट से जुड़े। प्रेज़ेंटर हर चैप्टर में एक जैसा रहता है, जिसकी गारंटी इस दाम में कोई असली शूट नहीं दे सकता।
ब्रांड का प्रवक्ता
कंपनी का हर वीडियो एक ही चेहरे से शुरू होता है, किसी कर्मचारी की उपलब्धता या उसके इस्तीफ़े पर निर्भर हुए बिना। कपड़े और सेट का वर्णन इमेज नोड में करें: चेहरा शीट संभालती है, संदर्भ शॉट संभालता है।
दूसरी भाषा बोलने वाला अवतार
जिस भाषा में चाहिए, संवाद उसी भाषा में उद्धरण चिह्नों के भीतर लिखें: Veo 3.1 Fast उसे बोलता है, होंठों की हरकत समेत। एक ही वीडियो इस तरह पाँच बाज़ारों में जाता है, वही प्रेज़ेंटर और पाँच संवाद।
वेबसाइट के होम पेज पर स्वागत वीडियो
आठ सेकंड, चेस्ट शॉट, धुँधला ऑफ़िस बैकग्राउंड: यही फ़ॉर्मैट होम पेज पर बिताया गया समय बढ़ाता है। वाक्य छोटा रखें, हर वीडियो में एक ही बात, और बिना आवाज़ देखने वालों के लिए सबटाइटल रखें।
TikTok और Reels के लिए वर्टिकल अवतार
टेम्पलेट पहले से 9:16 में रेंडर करता है। सिर के ऊपर स्क्रीन टेक्स्ट के लिए जगह छोड़ें, और एडिटिंग में पहला आधा सेकंड काट दें: वीडियो मॉडल अक्सर हल्के जमे हुए फ़्रेम से शुरू करते हैं।
आम ग़लतियाँ
आठ सेकंड के लिए बहुत लंबी स्क्रिप्ट
दो छोटे वाक्य एक टेक में आ जाते हैं। उससे ज़्यादा पर मॉडल रफ़्तार बढ़ा देता है या अंत काट देता है, और एक शब्द ठीक करने के लिए पूरा रेंडर दोबारा ख़रीदना पड़ता है।
रेंडर चलाने के बाद आवाज़ का वर्णन करना
आवाज़ उसी रेंडर से निकलती है जिससे इमेज: टोन, रफ़्तार और भाव प्रॉम्प्ट में, जनरेट करने से पहले लिखे जाते हैं। आवाज़ बदलने का मतलब है नया टेक।
चेहरे पर बहुत टाइट क्लोज़ अप
बहुत क़रीबी शॉट मुँह के आसपास की छोटी ख़ामियाँ उभार देते हैं। हल्का साइड से लिया चेस्ट शॉट हाथों की हरकत के लिए जगह छोड़ता है और टेक ज़्यादा भरोसेमंद लगता है।
आप उसे प्रॉम्प्ट में लिखते हैं, कास्टिंग नोट की तरह: टोन, रफ़्तार, इरादा। यह किसी लिस्ट से चुनी नहीं जाती, और एक ही टेक्स्ट के दो रेंडर में हल्का फ़र्क़ आ सकता है।
क्या मॉडल हिंदी बोलता है?
हाँ, और टेम्पलेट यही करता है। प्रॉम्प्ट में बोली जाने वाली लाइन कोट्स के अंदर हिंदी में लिखिए, बाक़ी ब्यौरा अंग्रेज़ी में रह सकता है, इससे बोली जाने वाली भाषा नहीं बदलती।
टेक ख़राब निकले तो?
दोबारा चलाइए। आठ सेकंड की एक टेक कुछ दर्जन सेंट के क्रेडिट की होती है, और नोड पिछले रेंडर की हिस्ट्री रखता है: दो वर्ज़न की तुलना करते वक़्त कुछ खोता नहीं।
लिप सिंक कितना सही बैठता है?
सही बैठता है, क्योंकि इमेज और बोली एक ही रेंडर से निकलती हैं: बाद में कुछ चिपकाया नहीं जाता। यही इस वर्कफ़्लो को उन पुरानी चेन से अलग करता है, जहाँ दसवें सेकंड का फ़र्क़ भी जोड़ ज़ाहिर कर देता है।
क्या अपना चेहरा इस्तेमाल किया जा सकता है?
हाँ, रेफ़रेंस शीट में अपनी तीन फ़ोटो डालकर। यह सिर्फ़ उसी चेहरे के साथ करें जिसने इजाज़त दी हो: किसी तीसरे की फ़ोटो से बना प्रवक्ता छवि के अधिकार का असली मसला खड़ा करता है।
आठ सेकंड के एक टेक पर कितना लगता है?
Veo 3.1 Fast के साथ क़रीब 144 क्रेडिट, यानी डेढ़ यूरो के आसपास, शुरुआती इमेज समेत। सटीक दाम रेंडर चलाने से पहले बटन पर दिखता है।
क्या कई संवाद एक के बाद एक जोड़े जा सकते हैं?
हाँ, हर संवाद के लिए एक वीडियो नोड, सब एक ही चेहरे वाली शीट और एक ही शुरुआती शॉट से जुड़े। सिरे से सिरे तक जोड़ने पर एक मिनट का वीडियो मिलता है, प्रेज़ेंटर पूरे वक़्त वही।
 Veo 3.1 Fast
 HeyGen Video 1
 Seedream 5 Pro
 Kling V3