貓咪的爆紅影片
貓咪在沙發上睡覺,接著「而牠腦中的世界」,再切到 trap 現場表演:把這兩段畫面前後剪接在一起,正是目前在 TikTok 和 Instagram 上流傳的格式。
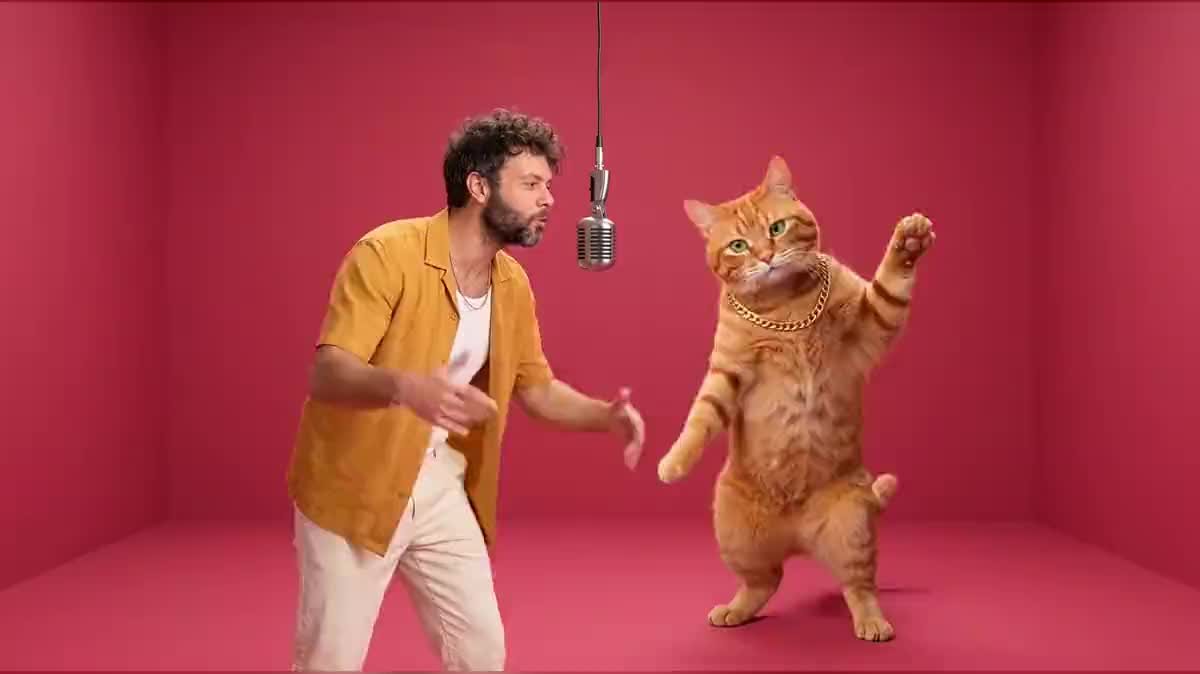
您的照片和貓咪的照片,變成一場 trap 音樂現場:您在懸掛麥克風前饒舌,巨貓則跳舞並用英文饒舌回應。這裡就能看到完整工作流程,無需帳號。
真實工作流程:Frank 的照片和一隻橘貓的照片進入同一張圖片,呈現一個有懸掛麥克風的覆盆子粉紅攝影棚,接著透過 Wan 3.0 產生 10 秒含聲音的影片:一段 trap 節奏,Frank 饒舌,巨貓則跳舞並用英文饒舌回應。
重點摘要
這個格式最近到處都能看到:在單一顏色牆面前拍攝的現場表演,一支從天花板垂下的麥克風,饒舌歌手旁邊站著一隻與他一樣高、邊跳舞邊搶麥克風的貓咪。這個工作流程會用您和您的貓咪重現這一切,只需要兩張照片。
最困難的地方在於同時保留兩者:您的臉和貓咪的毛色。因此兩張照片會一起進入同一張圖片,一次性完成整個場景的構圖;影片接著會以這張圖片為起點,不重新繪製任何東西,只加入節奏和聲音。
Wan 3.0 會一次性產生動作、trap 節奏和雙方的聲音,皆為英文,嘴型與您寫的歌詞完全同步。圖片加上 10 秒影片共需 139 點數。
這些是上方工作流程所產生的檔案,完全按照模型的原始輸出呈現,未經修飾。若有起始素材,將會標示出來。
起始素材
生成結果
在 TikTok 和 Instagram 上發文的貓咪飼主、追蹤潮流的創作者、想要製作獨特預告片的音樂人,以及收容所與寵物品牌。
一張臉部清晰的您的照片,以及一張在白天從正面拍攝的貓咪照片,再加上兩人各一句英文饒舌台詞。
提供兩張清晰的照片
一張臉部光線充足的您的肖像照,以及一張能清楚看到貓咪毛色和眼睛的照片。若貓咪蜷縮在陰影中,產生的巨貓會與牠本身不太相似。
選擇牆面顏色
選一種飽和色,讓牆面與地面融為一體:這裡使用覆盆子粉紅色,但橘色、薄荷綠或皇家藍也同樣適用。正是這種單色背景,讓人一眼就能認出這種格式。
在產生影片前先檢查圖片
您的臉、貓咪的條紋、牠站在您身邊的大小:一切都取決於這張圖片,費用為 19 點數。若在失敗的圖片上執行影片,則會額外花費 120 點數。
寫下您和貓咪的台詞
為您和貓咪各寫一句英文台詞,放在引號之間,就像流傳的那些影片一樣。模型會依序饒舌唸出這些台詞,貓咪則會用真正的饒舌歌手聲音接過麥克風。
同一塊畫布,針對不同需求微調:每個變化版本只要改兩三行提示詞。
貓咪在沙發上睡覺,接著「而牠腦中的世界」,再切到 trap 現場表演:把這兩段畫面前後剪接在一起,正是目前在 TikTok 和 Instagram 上流傳的格式。
朋友的照片和他們貓咪的照片,再把他們的名字寫進饒舌歌詞裡:10 秒鐘的合唱比一張卡片更有效果,還會在群組對話中被分享轉傳。
發布新歌的藝人可以和自己的貓咪拍一支風格獨特的預告片,寫上副歌的真實歌詞:這支影片能吸引目光,並引導觀眾去聽完整的歌曲。
志工站在麥克風前,待認養的貓咪則以巨大版在旁邊跳舞:影片的歌詞中會提到貓咪的名字,傳播效果遠比一般認養公告更好。
寵物飼料製造商或貓抓板店家,在取得客戶同意後,以顧客的貓咪為主角拍攝,讓這支影片成為一則看起來不像廣告的廣告。
同樣的合唱組合,搭配三種牆面顏色和三首曲目:三支影片在您的帳號上接續發布,就像一部系列作品的各集,每次都能認出同一隻貓咪。
只要提示詞中描述了臉部特徵,模型就會重新繪製一張臉,而不是保留照片中的臉。請描述您的服裝和動作,絕對不要描述您的五官。
若貓咪在照片中距離太遠、處於陰影中或蜷縮成一團,模型只能猜測牠的毛色:產生出來的巨貓看起來像一隻貓,卻不像您的貓。請在白天,從正面拍攝牠。
如果沒有明確禁止的句子,貓咪會退回發出貓叫聲,而不是饒舌。請在影片提示詞中保留「絕不發出貓叫聲」以及「真正人類饒舌歌手的聲音」這兩個描述。
影片會直接以圖片原本的樣子作為起點:如果貓咪太小,或麥克風位置不對,這些問題會在整支 10 秒影片中持續存在。重新產生圖片會便宜六倍。
模型會自行創作 trap 節奏,並饒舌唸出您寫的歌詞。若要搭配現有的音樂,請在剪輯節點中用您的音軌剪輯影片,並注意尊重該曲目的版權。
可以,只要在兩段提示詞中把「貓」換成「狗」即可。巨大版動物會保留照片中該動物的毛色和頭部特徵,並用同樣的饒舌歌手聲音饒舌。
因為這正是這種格式的標誌:一片素色牆面、一支懸掛麥克風,別無其他。過於複雜的場景會讓人認不出這種格式,也會讓目光從合唱的兩人身上移開。
共 139 點數:Nano Banana Pro 產生圖片需要 19 點數,Wan 3.0 產生 720p、含聲音的 10 秒影片需要 120 點數。單獨重新產生圖片則只需要 19 點數。
Seedance 2.5 不接受顯示真人的第一張畫面,而只要您出現在場景中,就會是這種情況。Wan 3.0 則能接受這種畫面,並一次性產生節奏、聲音和舞蹈動作。
不一定,這只是範例中的選擇,就像流傳的那些影片一樣,而且英文饒舌搭配 trap 節奏聽起來確實很合適。請保持台詞簡短:兩句清楚的台詞,勝過一整段歌詞。
可以,Wan 3.0 最長可達 30 秒,每秒的費用相同。這時可以寫四句台詞,輪流演唱,讓您和貓咪都能有各自站上麥克風的時刻。
可以,這是您的照片、您的貓咪,以及模型創作的音樂。當社群平台要求時,請將內容標示為 AI 生成,TikTok 和 Instagram 都提供這個選項。
 Nano Banana Pro
 Wan 3.0
 Seedance 2.5
 Kling V3