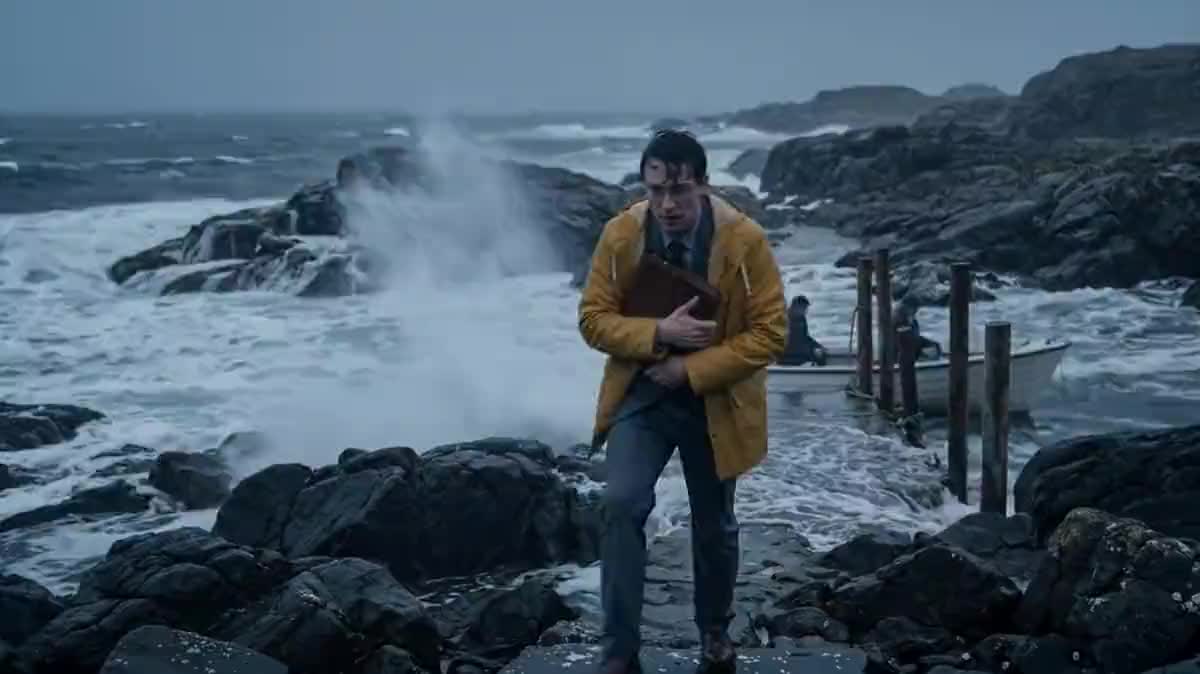
完整的短片,逐場拍攝
這就是示範內容:三個場景,各配一排節點,最後接上剪輯。若要製作十場戲的電影,每場複製一排節點,並讓同一份聖經連接到所有節點:正是它讓風格與人物臉孔從頭到尾保持一致。
將您的劇本 PDF 拖到畫布上:一個文字節點寫出視覺聖經,角色被繪製成人物設定圖,每個場景都拿到專屬的導演提示詞、首圖,以及一段對白演出完整的 Wan 3.0 影片,最後由剪輯拼接成整部電影。示範拍攝的是一份原創的三場劇本。整個工作流程無需帳號即可查看。
真實的工作流程:一份三場劇本 PDF 放入媒體節點,Claude Sonnet 5 先寫出視覺聖經,再逐場撰寫提示詞,Nano Banana Pro 負責角色設定圖與首圖,Wan 3.0 拍攝三個十五秒的場景,最後接上一個剪輯節點。畫面顯示的文字皆為模型的原始回覆,未經修改。
重點摘要
劇本本身已經是一種分場:場景、角色、場景設定、台詞。PDF 進入媒體節點,任何設定為可讀取文件模型的文字節點,都能透過其「要分析的圖片或 PDF」連接埠接收它。第一個節點寫出視覺聖經:一段要在各處重複套用的風格描述,每個角色以三句話說明,每個場景設定以兩句話說明。
聖經為後續一切提供依據。兩個接上 Nano Banana Pro 的圖片節點繪製角色設定圖:正面、四分之三側面、側面、全身。三個接上 Claude Sonnet 5 的文字節點,各自依照 Seedance 2.5 指南的格式,寫出一個場景的提示詞,交由 Wan 3.0 拍攝:風格說明、一句話摘要、三到四個標註時間的鏡頭,涵蓋十五秒,包含鏡位、運鏡方式、引用的台詞與聲音。每個場景都有自己的首圖,以兩張角色設定圖繪製並接上作為起始影像:人物臉孔在各場景之間保持一致。
示範拍攝的是《North of Silence》,一份為此範例特別撰寫的原創三場劇本:一位燈塔看守人、一位被派來熄燈的官員、一場風暴。對白由模型演出,使用英語,也就是 PDF 的語言。將劇本換成您自己的,把您的場景標頭複製進場景指令裡,每多一個場景就加一排節點,剪輯節點就會把一切拼接起來。每個場景的價格取決於其長度,可在影片節點上調整為 4 到 30 秒。
這些是上方工作流程所產生的檔案,完全按照模型的原始輸出呈現,未經修飾。若有起始素材,將會標示出來。
生成結果
作家、編劇與電影系學生,想在尋找拍攝團隊之前,先看看自己的劇本拍出來是什麼樣子。
一份文字版PDF劇本,格式可以是標準劇本格式或簡單的敘述文字,場景標示要清楚可讀:模型會讀完整份文件,從中萃取出視覺聖經。
將您的劇本 PDF 拖到畫布上
一個媒體節點會接收它。無論是標準劇本格式還是純文字都沒關係:模型會讀取整份文件。每個節點最多可放三份文件,因此角色聖經或大綱可以另外附上。
讓第一個節點寫出視覺聖經
接上 PDF 後,一個設定為可讀取文件模型的文字節點,會以三個簡短段落回覆風格、角色與場景設定。這段文字是撐起整部電影的核心:其餘一切都透過連線接收它。
生成角色設定圖
兩個圖片節點接收聖經,各自在中性背景上以四個視角繪製一個角色。這些設定圖會被放進每個場景的首圖中:正是這一步讓角色臉孔在各場景之間保持一致。多一個角色,就多一個節點。
每個場景各配一段提示詞、一張首圖與一段影片
每個場景的文字節點都會讀取 PDF 與聖經,寫出一段導演提示詞:標註時間的鏡頭、鏡位、運鏡、引用的對白、聲音。首圖確定第一個鏡頭的畫面框架,Wan 3.0 便以此為起點拍攝該場景,對白演出、聲音齊全。
在剪輯節點中拼接成電影
三個場景會依連線順序依次進入。剪輯會在瀏覽器中即時呈現,不消耗額度,並可匯出為 mp4。若要製作更長的電影,只需每場加一排節點,並調整每段影片的長度。
同一塊畫布,針對不同需求微調:每個變化版本只要改兩三行提示詞。
這就是示範內容:三個場景,各配一排節點,最後接上剪輯。若要製作十場戲的電影,每場複製一排節點,並讓同一份聖經連接到所有節點:正是它讓風格與人物臉孔從頭到尾保持一致。
只拍開場場景與關鍵場景,各二十秒,再用片名字卡剪接在一起:兩分鐘的畫布內容,用來展示導演的意圖,而不是用言語描述它。
一章小說的 PDF 同樣可行:這時聖經指令要請模型先把該章拆分成場景,並自行構思場景標頭。工作流程的其餘部分不變,找到幾個場景就配幾個場景節點。
若想測試一段雙人對白場景,只需保留一排節點,並將影片拉長到三十秒:Wan 3.0 會在一次生成中串接多個鏡頭,並保留引用的台詞與其說話者。
將影片節點換成額外的圖片節點,清單上每個鏡頭各配一個:您將得到人物一致的分鏡稿,價格只是影片的一小部分,可在正式拍攝前先展示。
設定圖必須放進「每一個」場景的首圖裡,而每段影片也必須從其首圖開始拍攝:一旦有起始影像,Wan 3.0 就會忽略其參考圖。此外,聖經必須描述兩到三個明顯特徵,並在每個場景提示詞中重複提及:這正是模型會遵循的依據。
一段兩頁的場景無法塞進十五秒:模型會刪減內容或開始自行發揮。請延長影片,最多到三十秒,或把場景拆成兩個節點,各配一排。
每個場景指令都會引用劇本中確切的場景標頭。如果您換了 PDF 卻沒有更新指令,模型就會去尋找一個不存在的場景。請在生成前先複製好您的場景標題。
「The request failed because the input image may contain real person」:目前 Seedance 2.5 會拒絕任何以真實人物照片級寫實影像作為輸入的情況,無論是設定圖或首圖,即使是生成出來的也一樣。因此這個範本改用 Wan 3.0 運作,它能毫無異議地接受人臉;提示詞仍維持 Seedance 指南的格式,待 ByteDance 重新開放人臉功能後,再放回該節點使用。
場景提示詞會以英語輸出,即使是法文劇本也是如此:因為這是影片模型最能準確遵循的語言。至於對白,則會維持提示詞中引用台詞所使用的語言。
文字節點會讀取整份 PDF,價格依其大小計算。示範內容為三個十五秒的場景,對應三排節點。一部十場戲的短片可用同樣方式建立,每場一排節點,或以三十秒為單位的場景區塊拍攝,這是 Wan 3.0 的最長時長。
是的:Wan 3.0 會根據提示詞中引用的台詞,以文字所使用的語言生成聲音與嘴形。示範使用英語,也就是劇本的語言。若劇本是法文,對白也會是法文。
一段 720p、十五秒的場景在 Wan 3.0 上約需 125 點額度,一張角色設定圖或一張首圖約需十點,讀取 PDF 則每個節點只需幾點額度。價格會在點擊前顯示於每個節點上,生成失敗會退還額度。
不需要。場景標頭、全大寫的人名和台詞有助於模型進行分場,但一整段連續文字同樣可行:聖經指令可以要求模型自行提出分場方案。
可以:只需在連接到相同連接埠的媒體節點中,用您的照片取代生成出來的設定圖即可。影片節點上已在使用的 Wan 3.0,能同樣妥善處理真實臉孔與生成臉孔。
使用提示詞中引用台詞的語言,也就是劇本本身的語言。示範使用英語。Wan 3.0 與 Seedance 2.5 皆能原生支援約十種語言。
每個剪輯節點最多可串接二十四個片段、共二百四十秒,並在瀏覽器中即時呈現,不消耗額度。超過此限制時,第二個剪輯節點可以接續處理。
它會與您的專案一起儲存,只會被您選擇的模型讀取,絕不會被用於其他任何地方。讀取費用會在上傳時依檔案大小預先保留,之後再依實際讀取的 token 數調整。
 Wan 3.0
 Claude Sonnet 5
 Nano Banana Pro
 Seedance 2.5