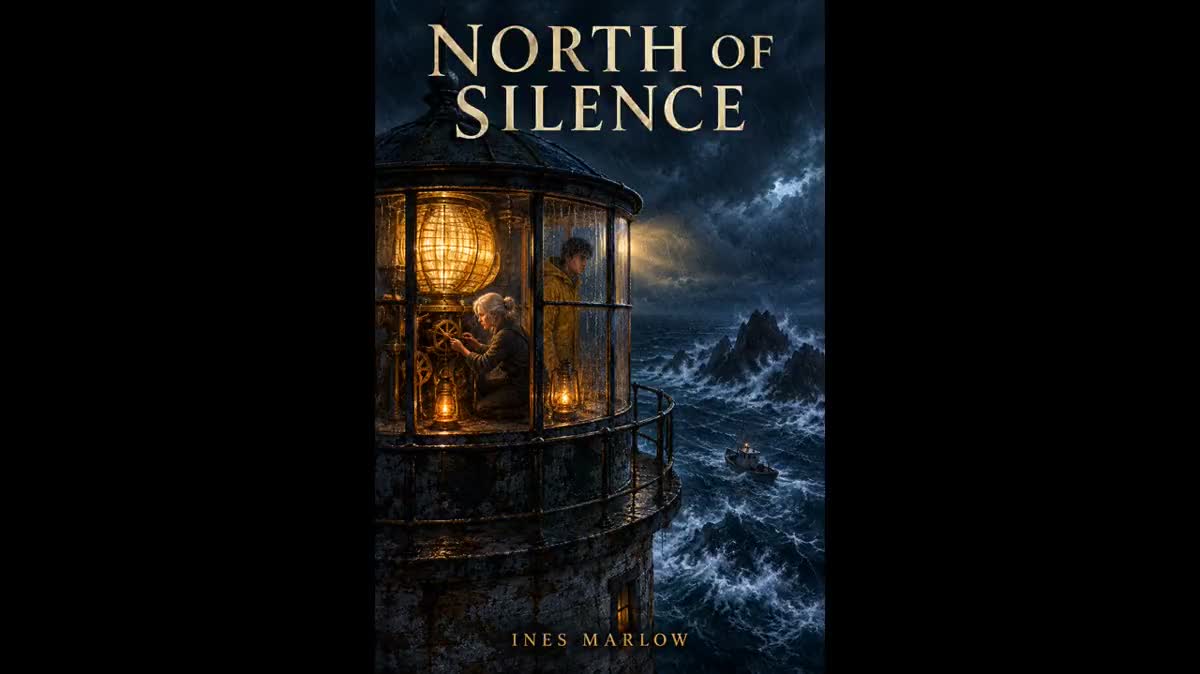
첫 챕터의 발췌본
이것이 바로 데모입니다: 한 글자도 빠짐없이 옮겨진 서두, 내레이터 목소리, 배경음, 화면 속 표지. PDF와 제목만 바꾸고 나머지는 그대로 두면, 영상이 여러분의 책에 맞게 다시 만들어집니다.
캔버스에 끌어다 놓은 PDF 챕터: Text 노드 하나가 그 서두를 한 글자도 빠짐없이 그대로 옮겨 적고, ElevenLabs 내레이터 목소리가 이를 읽어주며, 그 아래로 악기 연주가 흐르고, 표지는 16:9 Montage 화면에 그대로 유지됩니다: 첫 챕터를 들려주기 위해 올릴 영상입니다. 전체 워크플로우는 계정 없이도 확인할 수 있습니다.
실제 워크플로우: Media 노드에 담긴 PDF 형태의 소설 첫 챕터, 서두를 옮겨 적는 Claude Sonnet 5, 내레이션을 위한 ElevenLabs v3, 배경음을 위한 ElevenLabs Music, 표지를 위한 GPT Image 2.5 Flare, 그리고 Montage 노드. 화면에 표시된 텍스트는 모델의 응답 그대로이며, 손을 대지 않았습니다.
한눈에 보기
첫 챕터를 들려주는 것은 책을 위한 최고의 홍보입니다. PDF는 Media 노드에 들어가고, Text 노드가 '분석할 이미지 또는 PDF' 포트를 통해 이를 읽어 서두를 한 글자도 빠짐없이 그대로 옮겨 적습니다. 아무것도 다시 쓰지 않고, 1,400자가 되기 전 한 단락이 끝나는 지점까지: 1분 30초 분량의 낭독 길이입니다.
Voice-over 노드는 이렇게 연결된 텍스트를 ElevenLabs v3로 읽어주며, 목소리 목록에서 고른 내레이터 음성을 사용합니다. Music 노드는 연결된 브리프를 바탕으로 60초짜리 악기 연주 배경음을 작곡하고, Montage에서 낮은 볼륨으로 반복 재생됩니다. Image 노드는 GPT Image 2.5 Flare로 제목이 들어간 표지를 그리고, Montage는 내레이션이 이어지는 동안 검은 배경 위에 표지 전체를 그대로 유지합니다.
데모에서는 예시로 쓰인 오리지널 소설 'North of Silence'의 서두를 읽습니다. PDF는 여러분의 챕터로, 노드 속 목소리는 원하는 것으로, 표지 프롬프트의 제목은 여러분의 것으로 바꿔보세요. 챕터 전체는 3,000자 단위의 Voice-over 노드 여러 개로 읽어, Montage 안에서 이어붙일 수 있습니다. 표지와 예고편이 이 시리즈를 완성합니다.
위 워크플로에서 나온 파일이며, 모델이 생성한 그대로 보정 없이 표시됩니다. 시작점이 있는 경우 함께 표시됩니다.
렌더링 결과
스튜디오나 성우 없이 첫 챕터를 들려주고 싶은, 또는 완전한 오디오북 제작 전에 목소리를 테스트해보고 싶은 작가와 출판사.
스캔이 아닌 텍스트 PDF 챕터: Text 노드가 문장을 그대로 옮겨 적고, 목소리가 이를 문장 단위로 읽어줍니다.
PDF 챕터를 끌어다 놓으세요
Media 노드가 이를 받습니다. Text 노드는 요약이 아니라 서두를 그대로 옮겨 적습니다: 읽히는 것은 여러분의 문장 그대로, 문장 단위로, 한 단락이 끝나는 지점까지입니다.
목소리를 고르고 읽어보세요
Voice-over 노드는 케이블을 통해 텍스트를 받습니다. 약 20종의 ElevenLabs v3 음성, 또는 복제한 목소리 중에서 고를 수 있으며, 데모에서는 침착한 내레이터인 George를 사용합니다. 텍스트 속 [pause]나 [whispers] 태그가 연기를 안내합니다.
배경음을 작곡하고 표지를 그려보세요
Music 노드는 연결된 브리프를 바탕으로 60초짜리 악기곡을 작곡합니다. Image 노드는 3:4 표지 안에 제목을, 그리고 두 개의 크레딧을 써넣습니다. 둘 다 내레이션에 손대지 않고 다시 만들 수 있습니다.
편집하고 올려보세요
Montage는 16:9 화면에서 검은 배경 위에 표지 전체를 배치하고, 내레이션을 한 트랙에, 낮은 볼륨으로 반복되는 배경음을 다른 트랙에 놓은 뒤 마지막에 페이드를 넣습니다. 브라우저 안에서 렌더링되며, 크레딧 소모 없이 mp4로 내보낼 수 있습니다.
같은 캔버스를 다른 목적에 맞게 조정한 버전들: 각 변형은 프롬프트 두세 줄만 바꾸면 됩니다.
이것이 바로 데모입니다: 한 글자도 빠짐없이 옮겨진 서두, 내레이터 목소리, 배경음, 화면 속 표지. PDF와 제목만 바꾸고 나머지는 그대로 두면, 영상이 여러분의 책에 맞게 다시 만들어집니다.
3,000자 단위로 하나씩 배정된 Text 노드, 각각에 연결된 Voice-off 노드, 이 모두가 하나의 Montage 안에 들어갑니다: 15분짜리 챕터는 약 10개의 노드로 읽히며, 그 아래로 배경음이 반복 재생됩니다.
1분짜리 녹음으로 Voice-over 노드에서 여러분의 목소리를 복제한 뒤, 이를 내레이션 목소리로 선택하세요: 첫 챕터를 스튜디오 없이 여러분이 직접 읽게 됩니다.
Image 노드와 Montage를 제거하세요: 내레이션과 배경음은 노드에서 mp3로 바로 내보낼 수 있어, 팟캐스트 플랫폼이나 책 페이지에 사용할 수 있습니다.
Text 노드에 조각을 번역하도록 요청하고, Voice-over 노드의 언어를 설정한 뒤 표지는 그대로 두세요: 같은 영상이 같은 목소리로 영어, 스페인어, 독일어로도 존재하게 됩니다.
지시문은 문장을 그대로 옮겨 적으라는 것입니다. 모델이 요약을 한다면, 텍스트가 없는 스캔된 PDF를 읽은 것입니다: 원고를 페이지 이미지가 아니라 텍스트 PDF로 변환하세요.
Montage 안에서 음악은 내레이션 아래에 머물도록 0.25로 설정되어 있습니다. 멜로디가 뚜렷한 배경음은 귀를 끌어당깁니다: 브리프에는 특정 테마 없이, 타악기 없는 배경을 요청하세요.
Montage는 검은 배경 위에 이미지 전체가 담기도록 설정되어 있습니다. '덮기' 모드에서는 3:4 표지의 제목이 위아래로 잘려나갑니다: 발췌본에는 '담기' 모드를 유지하세요.
네, 조각으로 나눠서 가능합니다: Voice-over 노드 하나는 최대 3,000자까지 읽습니다. Text 노드에 다음 조각을 요청하고, Voice-over 노드를 복제한 뒤 Montage 안에서 조각들을 순서대로 이어붙이세요. 가격은 읽은 글자 수에 따라 달라집니다.
데모 기준 약 60크레딧입니다: 1,400자 내레이션(약 12크레딧), 60초짜리 배경음(약 50크레딧), 표지(2크레딧), PDF 읽기(2~3크레딧)입니다. 가격은 클릭하기 전 각 노드에 표시됩니다.
네: ElevenLabs v3는 쉼표, 마침표, 그리고 빈 줄로 구분된 단락을 표현합니다. 더 긴 정지를 원하면 [pause] 태그를, 속삭임을 원하면 [whispers] 태그를 사용하세요. 태그 자체는 소리로 읽히지 않습니다.
1분 30초에서 2분, 즉 1,400자에서 1,800자 사이가 적당합니다: 목소리와 장면을 충분히 자리 잡게 하면서도, 휴대폰으로 끝까지 들을 수 있을 만큼 짧습니다.
네, Voice-over 노드에서 텍스트를 다시 만들 필요 없이 가능합니다: 다른 음색을 고르고 낭독을 다시 실행하면 Montage가 자동으로 업데이트됩니다.
아니요, Montage에는 어떤 이미지 클립이든 충분합니다: 작가의 사진이나 장소를 그린 일러스트도 괜찮습니다. 다만 제목이 들어간 표지가 가장 잘 공유됩니다.
책 페이지, 소셜 네트워크, 혹은 팟캐스트의 0회차로: mp4는 16:9, 1080p로 출력되며 소리는 이미 믹싱되어 있습니다. 9:16 Montage로 세로 버전도 만들 수 있습니다.
 ElevenLabs v3
 Claude Sonnet 5
 GPT Image 2.5 Flare