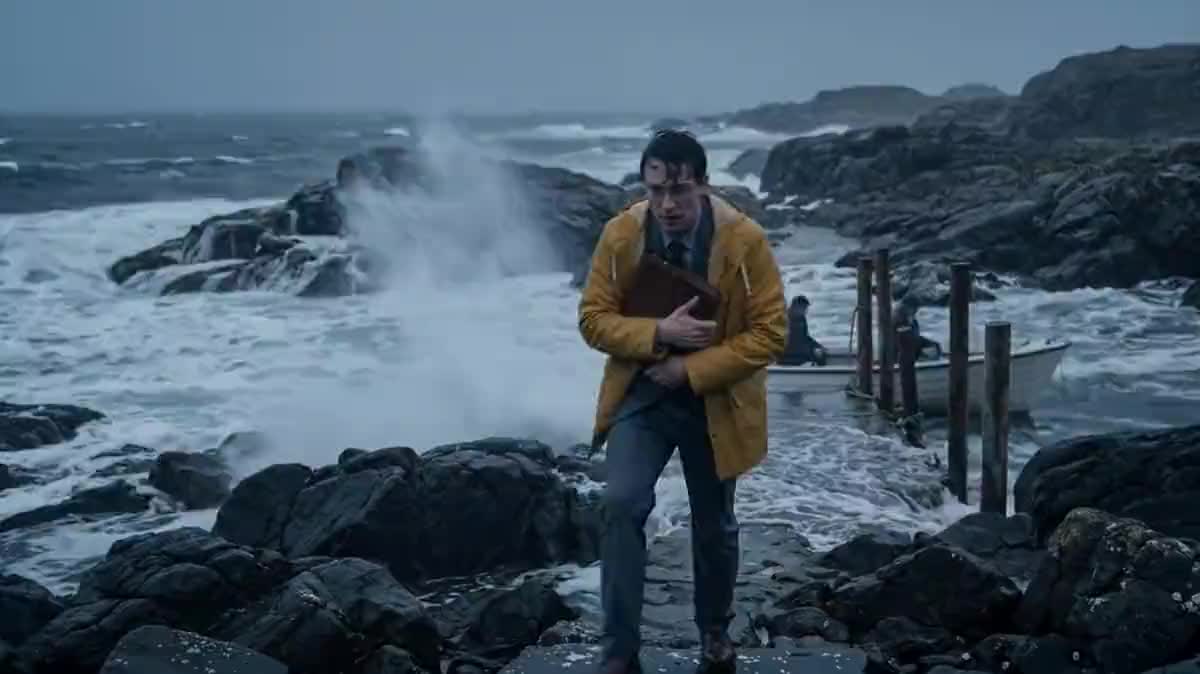
완성된 단편 영화, 장면별로
이것이 바로 데모입니다: 세 장면, 각각 노드 한 줄씩, 끝에 몽타주가 붙습니다. 열 장면짜리 영화를 만들려면 장면마다 한 줄씩 복제하고, 같은 바이블을 모든 곳에 연결해 두세요: 처음부터 끝까지 스타일과 얼굴을 유지해 주는 것이 바로 이 바이블입니다.
시나리오 PDF를 캔버스에 올려놓으면, Text 노드가 비주얼 바이블을 작성하고, 등장인물은 캐릭터 시트로 그려지며, 각 장면은 연출 프롬프트와 첫 프레임, 대사가 연기되는 Wan 3.0 영상을 받고, 몽타주가 영화를 이어 붙입니다. 데모는 세 장면으로 구성된 오리지널 시나리오를 촬영합니다. 전체 워크플로우는 계정 없이도 확인할 수 있습니다.
실제 워크플로우: Media 노드에 담긴 세 장면짜리 시나리오 PDF, 비주얼 바이블을 쓰고 이어서 장면별 프롬프트를 작성하는 Claude Sonnet 5, 캐릭터 시트와 첫 프레임을 만드는 Nano Banana Pro, 15초짜리 세 장면을 촬영하는 Wan 3.0, 그리고 Montage 노드. 화면에 보이는 텍스트는 모델의 답변을 그대로 옮긴 것입니다.
한눈에 보기
시나리오는 이미 하나의 분해도입니다: 장면, 인물, 배경, 대사로 나뉘어 있죠. PDF는 Media 노드에 들어가고, 문서를 읽는 모델로 설정된 Text 노드는 '분석할 이미지 또는 PDF' 포트를 통해 이를 받습니다. 첫 번째 노드는 비주얼 바이블을 씁니다: 어디서나 반복될 스타일 블록, 각 인물을 세 줄로, 각 배경을 두 줄로 정리합니다.
바이블이 나머지 작업의 기반이 됩니다. Nano Banana Pro로 작동하는 두 개의 Image 노드가 캐릭터 시트를 그립니다: 정면, 사분의 삼, 측면, 전신. Claude Sonnet 5로 작동하는 세 개의 Text 노드는 각각 Wan 3.0이 촬영할 Seedance 2.5 가이드 형식으로 한 장면씩 프롬프트를 씁니다: 스타일, 한 줄 요약, 15초 동안 타임스탬프가 찍힌 세네 개의 샷과 각 샷의 크기, 카메라 움직임, 인용된 대사, 사운드까지. 모든 장면에는 두 캐릭터 시트로 그려져 시작 이미지로 연결된 첫 프레임이 있어, 얼굴이 장면마다 그대로 유지됩니다.
데모는 예시를 위해 쓰인 세 장면짜리 오리지널 시나리오 'North of Silence'를 촬영합니다: 등대지기, 등불을 끄러 온 공무원, 그리고 폭풍. 대사는 모델이 연기하며, PDF의 언어인 영어로 진행됩니다. 시나리오를 여러분의 것으로 바꾸고, 슬러그라인을 장면 지시문에 그대로 옮겨 적고, 추가 장면마다 노드 한 줄을 더하면 몽타주가 전체를 이어 붙입니다. 장면의 가격은 길이에 따라 달라지며, Video 노드에서 4초에서 30초 사이로 조정할 수 있습니다.
위 워크플로에서 나온 파일이며, 모델이 생성한 그대로 보정 없이 표시됩니다. 시작점이 있는 경우 함께 표시됩니다.
렌더링 결과
팀을 구하기 전에 자신의 시나리오가 영화로 완성된 모습을 먼저 보고 싶은 작가, 시나리오 작가, 영화학과 학생들에게 유용합니다.
고전적인 형식이든 단순한 프로즈든, 슬러그라인이 잘 읽히는 텍스트 PDF 시나리오: 모델이 문서 전체를 읽고 여기서 비주얼 바이블을 도출합니다.
시나리오 PDF를 캔버스에 올려놓으세요
Media 노드가 이를 받습니다. 표준 시나리오 형식이든 일반 텍스트든 상관없습니다: 모델이 문서 전체를 읽습니다. 노드당 최대 세 개의 문서를 올릴 수 있어, 인물 바이블이나 시놉시스를 별도로 넣을 수도 있습니다.
첫 노드가 비주얼 바이블을 쓰도록 하세요
PDF에 연결된, 문서를 읽는 모델을 사용하는 Text 노드가 스타일, 인물, 배경을 세 개의 짧은 섹션으로 정리해 줍니다. 이 텍스트가 영화 전체를 하나로 묶어 주며, 나머지 모든 것은 케이블을 통해 이를 받습니다.
캐릭터 시트를 생성하세요
두 개의 Image 노드가 바이블을 받아 각각 한 인물을 중립적인 배경 위에 네 가지 각도로 그립니다. 이 시트들은 각 장면의 첫 프레임에 들어가는데, 이것이 바로 장면마다 같은 얼굴을 유지시켜 주는 요소입니다. 인물이 하나 늘면, 노드도 하나 늘립니다.
장면마다 프롬프트 하나, 첫 프레임 하나, 영상 하나
장면별 Text 노드는 PDF와 바이블을 읽고 연출 프롬프트를 씁니다: 타임스탬프가 찍힌 샷, 샷 크기, 카메라, 인용된 대사, 사운드까지. 첫 프레임이 첫 번째 샷의 프레이밍을 정하고, Wan 3.0이 이를 바탕으로 장면을 촬영하며, 대사가 연기되고 사운드도 포함됩니다.
Montage 노드에서 영화를 이어 붙이세요
세 장면은 케이블 순서대로 도착합니다. 몽타주는 브라우저에서 크레딧 없이 렌더링되며, mp4로 내보낼 수 있습니다. 더 긴 영화를 만들려면 장면마다 노드 한 줄을 추가하고 각 영상의 길이를 조정하세요.
같은 캔버스를 다른 목적에 맞게 조정한 버전들: 각 변형은 프롬프트 두세 줄만 바꾸면 됩니다.
이것이 바로 데모입니다: 세 장면, 각각 노드 한 줄씩, 끝에 몽타주가 붙습니다. 열 장면짜리 영화를 만들려면 장면마다 한 줄씩 복제하고, 같은 바이블을 모든 곳에 연결해 두세요: 처음부터 끝까지 스타일과 얼굴을 유지해 주는 것이 바로 이 바이블입니다.
오프닝 장면과 핵심 장면만, 각각 20초씩 촬영해서 타이틀 카드와 함께 이어 붙이세요: 연출 의도를 설명하는 대신 보여줄 수 있는, 캔버스 위 2분짜리 결과물입니다.
PDF로 된 소설 챕터도 마찬가지로 작동합니다: 이 경우 바이블 지시문에서 챕터를 장면으로 나누고 슬러그라인을 새로 만들어 달라고 요청합니다. 워크플로우의 나머지 부분은 동일하며, 발견된 장면마다 노드 하나씩입니다.
두 인물이 등장하는 장면을 테스트하려면 노드 한 줄만 유지하고 영상을 30초로 늘리세요: Wan 3.0이 한 번의 생성으로 여러 샷을 이어 붙이며, 인용된 대사와 발화자도 함께 처리합니다.
Video 노드를 목록에 있는 샷마다 하나씩 추가 Image 노드로 바꾸세요: 일관된 인물이 등장하는 스토리보드를 영상 가격의 일부만으로 얻을 수 있으며, 촬영 전에 보여줄 자료로 쓸 수 있습니다.
캐릭터 시트는 모든 장면의 첫 프레임에 들어가야 하며, 모든 영상은 자신의 첫 프레임에서 시작해야 합니다: 시작 이미지가 있으면 Wan 3.0은 참조 이미지를 무시해 버립니다. 그리고 바이블에는 두세 가지 특징적인 요소를 적어 두고, 이를 모든 장면 프롬프트에서 반복해야 합니다: 모델이 따라가는 것이 바로 이 부분입니다.
두 페이지짜리 장면은 15초에 담기지 않습니다: 모델이 내용을 잘라내거나 즉흥적으로 만들기 시작합니다. 영상을 최대 30초까지 늘리거나, 장면을 두 개의 노드로 나눠 각각 한 줄씩 배치하세요.
각 장면 지시문은 시나리오의 정확한 슬러그라인을 인용합니다. 지시문을 바꾸지 않고 PDF만 교체하면, 모델이 존재하지 않는 장면을 찾게 됩니다. 생성하기 전에 장면 제목을 그대로 옮겨 적으세요.
"The request failed because the input image may contain real person": Seedance 2.5는 현재 시트든 첫 프레임이든, 생성된 것이라도 사람의 포토리얼 이미지가 입력으로 들어오면 거부합니다. 그래서 템플릿은 얼굴을 거리낌 없이 받아들이는 Wan 3.0으로 돌아가며, 프롬프트는 Seedance 가이드 형식을 그대로 유지해 ByteDance가 얼굴 관련 제한을 다시 풀 때 노드에 되돌려 놓을 수 있게 합니다.
장면 프롬프트는 프랑스어 시나리오라도 영어로 작성됩니다: 영상 모델이 가장 잘 따르는 언어이기 때문입니다. 반면 대사는 프롬프트에 인용된 대사의 언어를 그대로 유지합니다.
Text 노드는 PDF 전체를 읽으며, 가격은 그 크기에 따라 달라집니다. 데모는 15초짜리 세 장면, 즉 노드 세 줄로 구성됩니다. 열 장면짜리 단편도 같은 방식으로, 장면당 한 줄씩, 또는 Wan 3.0의 최대 길이인 30초 단위 장면 블록으로 만들 수 있습니다.
네: Wan 3.0은 프롬프트에 인용된 대사를 바탕으로 목소리와 입술 움직임을 생성하며, 텍스트의 언어를 따릅니다. 데모는 시나리오의 언어인 영어로 진행됩니다. 한국어 시나리오라면 대사도 한국어로 나옵니다.
720p의 15초짜리 장면은 Wan 3.0에서 약 125 크레딧, 캐릭터 시트나 첫 프레임은 약 10 크레딧, PDF 읽기는 노드당 몇 크레딧이 듭니다. 가격은 클릭하기 전에 각 노드에 표시되며, 생성이 실패하면 환불됩니다.
아니요. 슬러그라인, 대문자로 쓴 이름, 대사는 모델이 장면을 나누는 데 도움이 되지만, 줄글로 된 일반 텍스트도 문제없이 작동합니다: 바이블 지시문에서 모델에게 장면 구분을 제안해 달라고 요청할 수 있습니다.
네: 같은 포트에 연결된 Media 노드에서 생성된 시트를 여러분의 사진으로 교체하세요. Video 노드에서 이미 사용 중인 Wan 3.0은 실제 얼굴도 생성된 얼굴만큼 잘 유지합니다.
프롬프트에 인용된 대사의 언어, 즉 시나리오의 언어로 연기됩니다. 데모는 영어로 진행됩니다. Wan 3.0과 Seedance 2.5는 약 10개 언어를 기본적으로 지원합니다.
Montage 노드당 최대 24개의 클립, 240초까지 가능하며, 크레딧 없이 브라우저에서 렌더링됩니다. 그 이상은 두 번째 Montage 노드가 이어받습니다.
PDF는 여러분의 프로젝트와 함께 저장되고, 선택한 모델이 이를 읽으며, 다른 곳에 재사용되는 일은 없습니다. 읽기 비용은 업로드 시 파일 크기에 따라 예약되며, 이후 실제로 읽힌 토큰 수에 맞춰 조정됩니다.
 Wan 3.0
 Claude Sonnet 5
 Nano Banana Pro
 Seedance 2.5