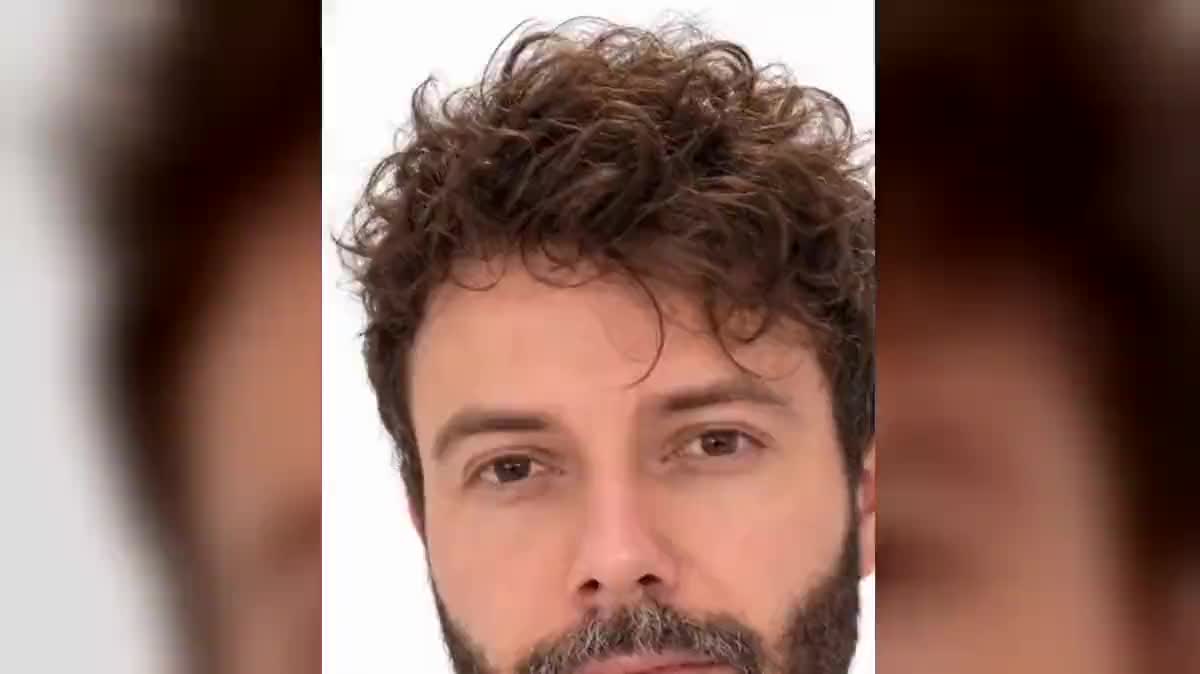
生日祝福訊息
壽星的照片,配上二十個字、由溫暖語音朗讀的文字:這正是示範中的第二個範例。影片可直接透過訊息傳送,完全不用自己拍攝。
一張人臉照片,加上由目錄語音朗讀的文字:InfiniTalk 讓照片中的人開口說話,嘴型、眨眼、頭部動作一應俱全。影片時長取決於語音時長。整個工作流程無需帳號即可預覽。
真實工作流程如下:一張照片放入媒體節點,兩段文字各由一個「配音」節點朗讀,兩個設定為 InfiniTalk 的影片節點分別透過圖片端口接收照片、透過語音端口接收語音。
重點摘要
只需一張照片即可。不用拍攝影片,也不用設定虛擬形象:照片中的臉開始說話,嘴型精準對上每個音節,還有眨眼、伴隨語句的細微點頭動作。成果看起來就像對著鏡頭拍攝的實景,而它其實只源自一張手機肖像照。
文字在「配音」節點中朗讀,可選用目錄中的一種語音(首推 ElevenLabs v3)或您克隆的語音。設定為 InfiniTalk 的影片節點接收照片與語音,並輸出一段長度恰好等於音訊長度的影片,最長可達二十八秒。價格依此時長計算,以檔案實際長度為準,點擊前即會顯示。
這就是會說話的虛擬形象的手法,但用的是您本人的臉,或是生成角色、手繪吉祥物、老照片中的臉。生日祝福、產品介紹、社群公告:示範中展示了同一張照片說出兩段不同訊息的情況。
這些是上方工作流程所產生的檔案,完全按照模型的原始輸出呈現,未經修飾。若有起始素材,將會標示出來。
起始素材
生成結果
一張正面照片,臉部清晰、光線充足,嘴巴閉合。要說的文字盡量簡短:影片長度會等同於語音長度。
選擇一張正面照片
臉部清晰、嘴巴閉合且可見、光線正面、背景簡單。手機拍的肖像照就很合適。眼鏡和鬍子沒問題,但手擋住嘴巴或側臉照則不行。
撰寫文字並選擇語音
「配音」節點會用您選擇的語音,以您指定的語言朗讀您寫的文字。二十個字的句子大約需要七到八秒。請先生成語音:它決定了影片的時長與價格。
生成影片
InfiniTalk 節點會顯示語音的實際時長與確切價格。點擊後:臉部就會開始說話,可選 480p 用於社群平台,或 720p 用於需要投影的畫面。
文字太長時,分段串接
語音超過二十八秒時,將文字拆成兩段分別生成,再用「剪輯」節點免費將它們前後串接,和其他影片工作流程一樣。
同一塊畫布,針對不同需求微調:每個變化版本只要改兩三行提示詞。
壽星的照片,配上二十個字、由溫暖語音朗讀的文字:這正是示範中的第二個範例。影片可直接透過訊息傳送,完全不用自己拍攝。
一張生成的肖像就能變成主持人:發布文字放入「配音」節點,照片放入媒體節點,影片以 720p 輸出,適合用於產品頁面或 UGC 廣告。
一張數位化的家庭合照,搭配以第一人稱撰寫的文字:臉部就會動起來並開口說話。若照片尺寸較小或有損傷,先用「畫質提升」節點處理,再送入 InfiniTalk。
只要嘴型清晰可辨的手繪角色也適用:模型可以像處理照片一樣,為插畫的嘴唇添加動畫。非常適合搭配目錄中活潑的語音,在社群媒體上發布品牌公告。
一張照片,三個不同語言的「配音」節點,三個 InfiniTalk 節點:同一個人可以說出英語、西班牙語、法語,每次嘴型都精準對上。若要從已拍好的影片開始,可參考配音替換。
將生成的影片送入讓照片跳舞,或作為參考素材放入影片節點:先說話,接著讓身體動起來。
模型需要看到完整的嘴巴。正面或輕微四分之三側臉時,同步效果乾淨俐落;側臉時嘴唇會變形。
露齒微笑、手放在下巴上、麥克風擋在前面,這些都會造成問題。嘴巴閉合、臉部清晰,成果才會乾淨。
InfiniTalk 節點的提示詞描述的是態度,不是文字內容。人物所說的內容由連接的語音決定:文字應該寫在「配音」節點中。
超過二十八秒時,節點會在生成前直接拒絕,不會扣款。請拆成兩段分別生成,再用「剪輯」節點串接。
每次生成可從兩秒到二十八秒,以正常語速計算大約六十個字。影片時長恰好等於串接的語音時長:無需另外調整。
可以。將錄音檔上傳到媒體節點並連接到語音端口,或在「配音」節點中克隆您的聲音,讓它朗讀任何文字。
兩者皆可。由圖片節點生成的肖像、手繪吉祥物或老照片,都能像自拍照一樣正常說話,只要臉部朝前、嘴巴清晰可見即可。
不會。啟動時系統會先預留金額,若發生技術性失敗會自動退還。點擊按鈕前即會顯示確切金額。
會說話的虛擬形象透過 Veo,一次性生成一位帶有自己聲音的虛構主持人。而這裡則是您本人的照片開口說話,語音可自由選擇,且更改文字時無需重新生成角色。
可以,在「配音」節點中選擇:ElevenLabs 的語音支援十四種語言朗讀。無論語言為何,嘴型同步都會依聲音精準對應。
InfiniTalk 輸出的畫面比例接近原始照片,解析度為 480p 或 720p。若需要特定比例,之後可在「剪輯」節點中重新裁切,支援 9:16、1:1 與 16:9。
每個節點只能處理一個人。若要呈現對話,可讓兩張照片分別配上各自的語音說話,再用「剪輯」節點交替呈現不同畫面。
 InfiniTalk
 HeyGen Video 1
 ElevenLabs v3
 Sync Lipsync 3
 Veo 3.1 Fast