カテゴリー
AIによるボイス、サウンド、音楽:ボイスオーバー、楽曲、ポッドキャスト、効果音、音声クリーンアップ
ボイスオーバーの生成、歌詞に曲をつける、2人の声によるポッドキャストエピソードの制作、一文で説明した効果音の作成、楽曲からのボーカル分離、録音のノイズ除去まで、それぞれの作業に対応するワークフローがここにあり、実際に聴ける音声ファイルも用意されています。
各ページでは、同じテキストや同じファイルで複数のエンジンを比較できることが多く、それぞれのコストも確認できます。クレジットを使う前に、声や手法を選ぶ最も確実な方法です。
ここでできること
- マイクもスタジオもなしで説得力のあるボイスオーバーを用意する
- 歌詞に曲をつける
- 録音なしでポッドキャストを作る
- ボーカルを分離してカラオケトラックを作る
- 録音から背景ノイズを除去する
このカテゴリーのツール 9個のツール
オーディオブック
読み上げられる章と、画面に映るカバー
キャンバスにドロップされたPDF版の一章:1つのTextノードがその冒頭を一語一句そのまま書き写し、ElevenLabsの語り手の声がそれを読み上げ、下でインストゥルメンタルの音の層が流れ、表紙は16:9のMontageの画面に留まり続けます。第一章を聴いてもらうために公開する動画です。ワークフロー全体がアカウントなしで見られます。

 インタラクティブデモ
 新着
脚本の読み合わせ
10行、3つの声、ワンテイク
PDFの脚本をキャンバスにドラッグするだけ。Textノードが10のセリフを抜き出し、読み上げ準備が整います。地の文を語るナレーターと、台詞をそのまま話す登場人物たち。そしてVoiceノードのダイアログモードが、3つのElevenLabsの声でそれらを1テイクで演じます。役者に頼んで行うようなリーディングが、3クリックで完成します。ワークフロー全体はアカウントなしで確認できます。
インタラクティブデモ 新着
歌をつくる
あなたの歌詞を、二度歌う
同じ歌詞を ElevenLabs Music が二度歌います。明るいポップとアコースティックフォーク、各1分。ワークフロー全体を登録なしで、二曲とともに見られます。
 インタラクティブデモ
 新着
効果音ジェネレーター
絵ではなく、音を描写する
ElevenLabs Sound Effects がテキストから作る三つの効果音。ループするトタン屋根の雨、きしむ城の扉、沸き立つスタジアム。ワークフロー全体を登録なしで見られます。
 インタラクティブデモ
 新着
二人の声のポッドキャスト
8つのセリフ、2つの声、1テイク
二人の司会者による8つのセリフのやり取りを、ElevenLabs Dialogue v3 が1テイクで演じます。二つの声、掛け合い、笑い。ワークフロー全体を登録なしで、エピソードとともに見られます。
 インタラクティブデモ
 新着
自分の声を変える
同じ一文、同じリズム、三つの声色
男性の声で言った一文を、ElevenLabs Voice Changer が女性、若い男性、年配の男性の三つの声で、元のリズムと抑揚のまま言い直します。アカウント登録なしで、ワークフロー全体をそのまま見られます。
 インタラクティブデモ
 新着
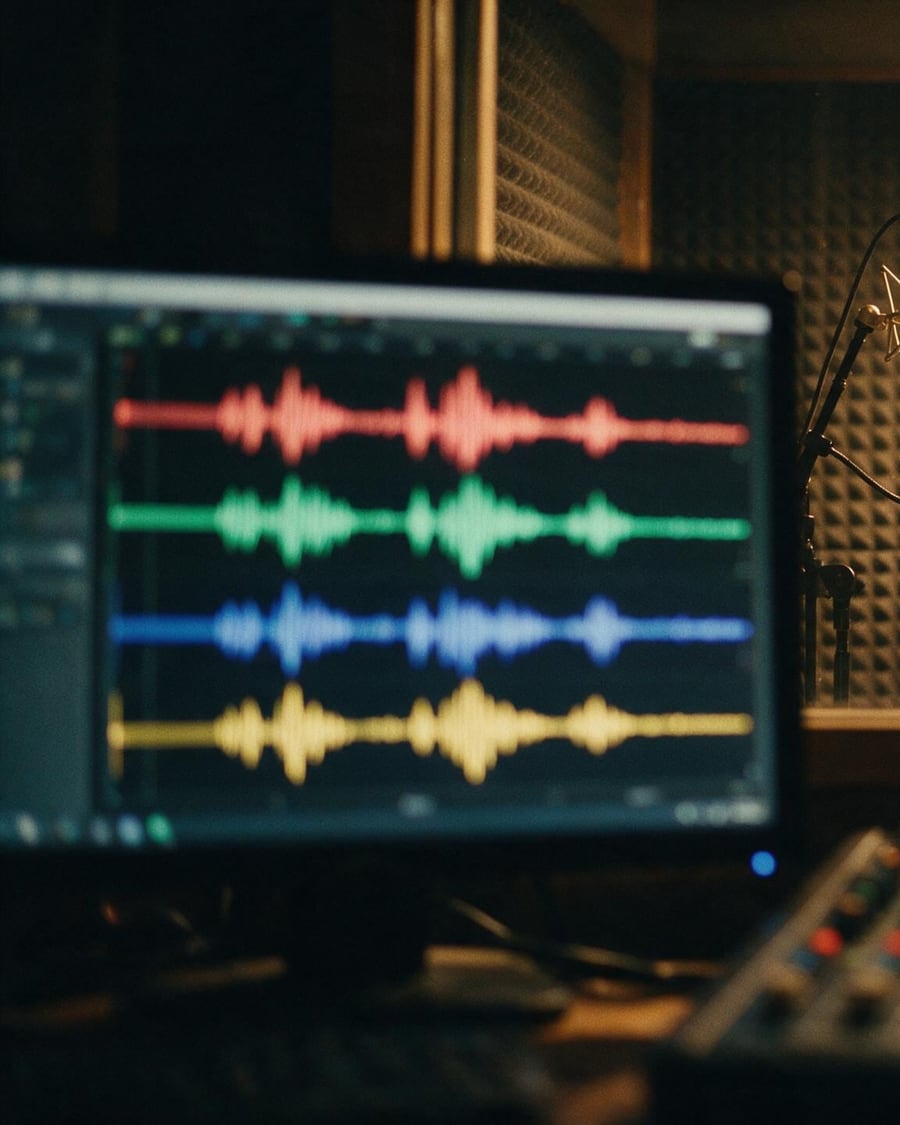
曲からボーカルを分離
ボーカル、ドラム、ベース、そしてカラオケ
30秒の曲を Demucs がボーカル、ドラム、ベース、その他の四つに分離し、隣では同じ曲をボーカル抽出に通します。アカウント登録なしで、ワークフロー全体をそのまま見られます。
インタラクティブデモ 新着
録音をきれいにする
声は残り、通りの音は消える
騒がしいテラスで吹き込んだ音声メモを、カタログの二つのノイズ除去、DeepFilterNet 3 と ElevenLabs Audio Isolation に並べて通します。アカウント登録なしで、ワークフロー全体をそのまま見られます。
インタラクティブデモ 新着
ナレーション:三つのエンジン
同じ文章を三つの声で聴き比べ
同じ原稿を ElevenLabs v3、MiniMax Speech 2.8 HD、OpenAI TTS HD の三つの音声合成エンジンが読み上げ、ナレーションを耳で選べます。アカウント登録なしで、ワークフロー全体をそのまま見られます。
 インタラクティブデモ
よくある質問
生成前に結果を聴くことはできますか?
はい:各ページには、紹介しているワークフローで生成されたデモの音声ファイルが埋め込まれています。聴こえる音声は、そのノードが実際に生成するものです。
生成した声を商用利用できますか?
生成された声はプロジェクト内で利用できます。実在する人物の声を複製するには本人の同意が必要であり、モデルは著名人の声の生成を拒否します。