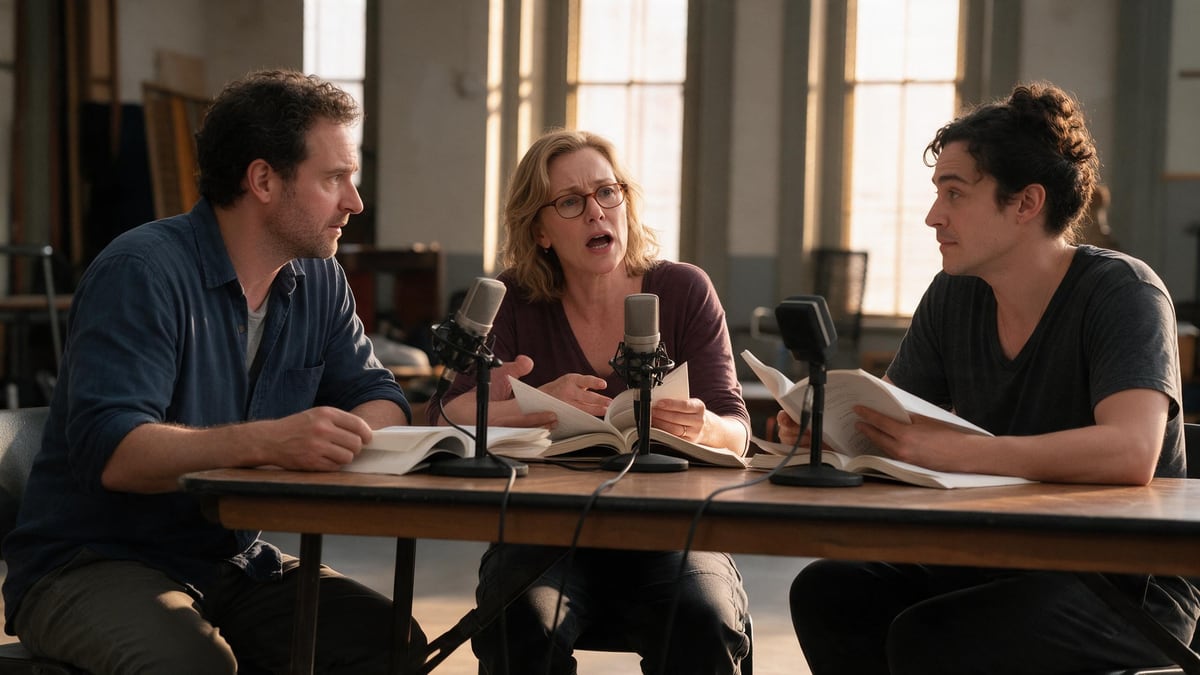
対話シーンのリーディング
これがデモの内容です:10のセリフ、2人の登場人物とナレーター、1テイクです。より長いシーンの場合は、10行ずつのVoiceノードを2つ、Montageノードでつなぎます。
PDFの脚本をキャンバスにドラッグするだけ。Textノードが10のセリフを抜き出し、読み上げ準備が整います。地の文を語るナレーターと、台詞をそのまま話す登場人物たち。そしてVoiceノードのダイアログモードが、3つのElevenLabsの声でそれらを1テイクで演じます。役者に頼んで行うようなリーディングが、3クリックで完成します。ワークフロー全体はアカウントなしで確認できます。
実際のワークフロー:3シーン分の脚本原文のPDFをMediaノードに配置し、Claude Sonnet 5が10のセリフを抜き出します。VoiceノードはダイアログモードでElevenLabs Dialogue v3を使い、3つの声で演じます。表示されているテキストはモデルの回答そのままで、修正はありません。
概要
対話は耳で判断するしかありません。脚本のPDFをMediaノードに入れると、Textノードが「解析する画像またはPDF」のポートからそれを読み取り、NAME:テキストという形式で10のセリフを抜き出します。ナレーターが本質的な動作を一文で語り、登場人物たちは脚本どおりに台詞をそのまま話します。
ダイアログモードのVoiceノードがこの10のセリフを保持し、それぞれに声が割り当てられます。ElevenLabs Dialogue v3がこれらを一度の演奏で演じます。テンポや沈黙、掛け合いのタイミングはすべてモデルによるもので、編集によるものではありません。デモでは3つの声を使用しています:低い声のナレーター、Marenのための成熟した女性の声、Eliasのための青年の声です。
デモでは「North of Silence」の第2場と第3場を読み上げています。これは脚本から映画へテンプレートの原作脚本です。1ノードにつき10のセリフ:次のシーンに進むには、Voiceノードを複製して、Textノードが書いた次の10のセリフを貼り付けてください。PDFとその指示内の登場人物名を、ご自身の脚本のものに置き換えてください。
これらは上記ワークフローの生成ファイルであり、モデルが出力したものをそのまま、加工なしで掲載しています。出発点がある場合はそれも表示しています。
レンダリング結果
対話を書き直したり役者に読んでもらう前に、その響きを確認したい脚本家、劇作家、フィクション作家の方々。
テキスト形式のPDFによる脚本または章:大文字の人物名とスラグラインがあると、地の文と台詞の区別に役立ちます。
脚本のPDFをドラッグしてください
Mediaノードがそれを受け取ります。できれば古典的な脚本形式が望ましいです:大文字の人物名とスラグラインがあると、モデルが地の文と台詞を区別しやすくなります。
Textノードにセリフを書かせましょう
NAME:テキストという形式で10行を出力します。指示内で読ませたいシーンと登場人物名を指定してください。NARRATORが動作を要約し、登場人物たちは台詞をそのまま話します。
セリフをVoiceノードに貼り付けましょう
ダイアログモードのVoiceノードには専用の行があります:1行に1セリフ、リストから登場人物ごとに1つの声を選びます。1ノードにつき10行、次のシーンには第2のノードを使ってください。
聴いてから調整しましょう
1テイクでやり取り全体が演じられます。あるセリフが平坦すぎると感じたら、[sighs]や[whispers]のような演技タグをテキストに加えてください。声が合わない場合は、その行だけを変更してください。ノード全体を変える必要はありません。
同じキャンバスを、別の用途に合わせて調整。各バリエーションは、プロンプトを2〜3行変えるだけです。
これがデモの内容です:10のセリフ、2人の登場人物とナレーター、1テイクです。より長いシーンの場合は、10行ずつのVoiceノードを2つ、Montageノードでつなぎます。
小説の1章をPDFにしても機能します:ナレーターが地の文を読み、登場人物たちが引用符内の台詞を話します。Textノードには正確な文をそのまま保つよう指示してください。
1ページ分のセリフ枠を、登場人物名付きで1行ずつ入力します。Voiceノードがそのページを演じ、Montageノードが音声とともに画面に配置します。
Voiceノードを複製し、各コピーで1人の登場人物の声だけを変更します:3テイク、3種類の声質を、1分ほどで耳で比較できます。
Textノードにセリフの翻訳を依頼し、Voiceノードの言語を設定してください。ElevenLabs Dialogueは同じ声のまま14言語に対応しています。
ダイアログモードは1テイクにつき10行までです。30セリフのシーンなら、Voiceノードを3つに分け、Montageノードでテイクの間に0.5秒の無音を挟んでつなぎます。
近い声質同士だとモノローグのように聞こえてしまいます。より細かい調整を試す前に、低い声と明るい声、あるいは女性の声と男性の声を選んでください。
ナレーターは動作を一文で語るべきで、脚本の括弧書きの指示までは読みません。Textノードの指示にはその旨が記されています:貼り付ける前に10行を確認してください。
ダイアログモードはそれぞれに声を割り当てた行を保持し、1テイクにつき最大10行まで扱います。これがモデルが一度の演奏で演じる内容です。Textノードが適切な形式に整えてくれるので、貼り付けは10秒で済みます。
ElevenLabsの声は20種類ほどあり、10のセリフに登場する人物数だけ使えます。デモでは3つ:ナレーター、Maren、Eliasです。対照的な声質を選ぶ方が、モノローグよりも聞き分けやすくなります。
10のセリフでおよそ10クレジット:Claude Sonnet 5によるPDFの読み取りと、文字数課金のElevenLabsのダイアログです。価格はクリック前にノード上に表示されます。
はい:ライブラリからクローンした声も、他の声と同様に行ごとに選択できます。まずVoice-overノードで声をクローンし、その後登場人物に割り当ててください。
呼吸のタイミングはモデル自身が配置します。本当の無音が必要な場合は、リーディングを2つのノードに分割し、Montage内でその間に1秒空けてください。
セリフの言語で、Voiceノード上で設定します。デモでは英語ですが、14言語が利用可能です。フランス語の脚本はフランス語で、同じ声を使って読まれます。
はい:表紙やシーンの画像をクリップとして使ったMontageノードに、リーディングを音声トラックとして重ねれば、SNS向けやプロダクション用のmp4として書き出せます。
 ElevenLabs Dialogue v3
 Claude Sonnet 5
 Grok TTS