完全な短編映画をシーンごとに
これがデモです。3シーン、それぞれ1行のノード、最後にモンタージュ。10シーンの映画にするには、シーンごとに行を複製し、同じバイブルをすべてに接続したままにしてください。これがスタイルと顔を最初から最後まで保つ要となります。
脚本のPDFをキャンバスにドロップすると、Textノードがビジュアルバイブルを書き出し、キャラクターがシート化され、各シーンに監督プロンプト、最初のフレーム、セリフを演じたWan 3.0の映像が生成され、モンタージュが映画としてつなぎます。デモでは3シーンのオリジナル脚本を撮影します。ワークフロー全体はアカウントなしで確認できます。
実際のワークフロー:3シーンの脚本PDFをMediaノードに入れ、Claude Sonnet 5がビジュアルバイブルとシーンごとのプロンプトを執筆、Nano Banana Proがキャラクターシートと最初のフレームを生成、Wan 3.0が15秒の3シーンを撮影し、Montageノードで仕上げます。表示されているテキストはモデルの回答そのもので、手を加えていません。
概要
脚本はすでに設計図です。シーン、キャラクター、セット、セリフが揃っています。PDFはMediaノードに入り、文書を読めるモデルに設定されたTextノードは「解析する画像またはPDF」ポートを通じてそれを受け取ります。最初のノードはビジュアルバイブルを書きます。全体で繰り返すスタイルのブロック、各キャラクターを3行で、各セットを2行で表現します。
このバイブルが残りの工程を支えます。2つのImageノードがNano Banana Proでキャラクターシートを描きます。正面、斜め45度、側面、全身です。3つのTextノードがClaude Sonnet 5でそれぞれ1シーン分のプロンプトを、Wan 3.0で撮影されるSeedance 2.5ガイド形式で書きます。スタイル、1文の要約、15秒間に3〜4カットのタイムスタンプ付きショット(ショットサイズ、カメラの動き、引用されたセリフ、音を含む)です。各シーンには最初のフレームがあり、2枚のシートを使って描かれ、開始画像として接続されます。これにより顔立ちがシーンをまたいで一貫します。
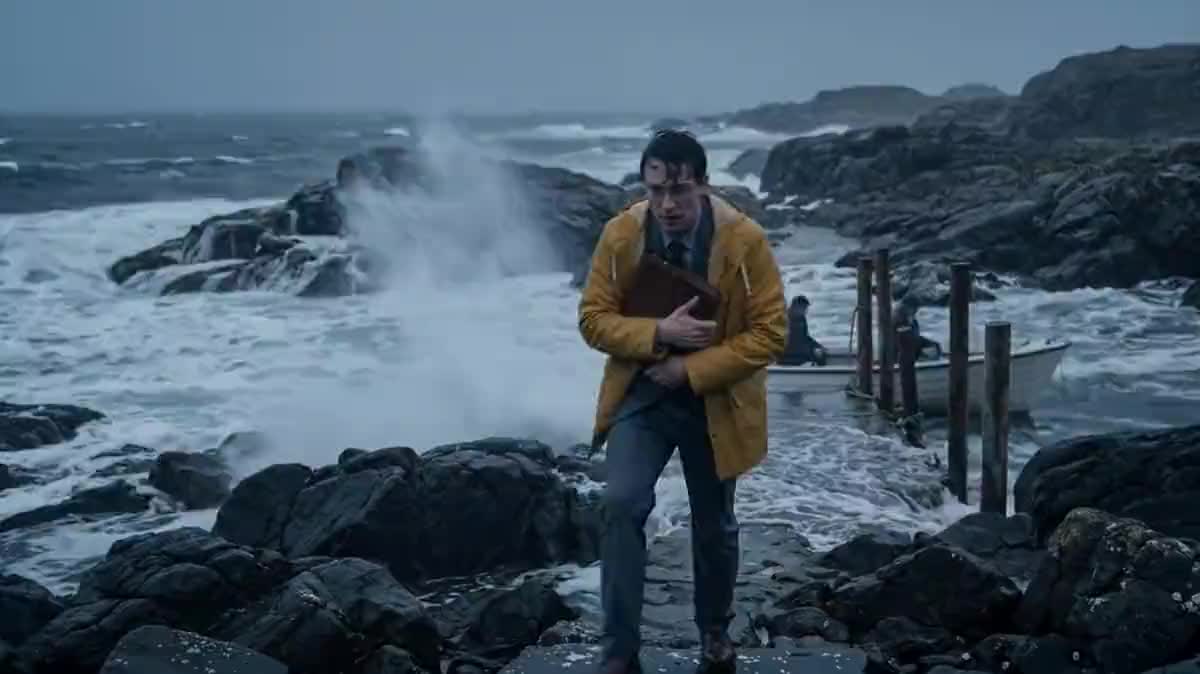
デモでは「North of Silence」を撮影します。これは例として書かれた3シーンのオリジナル脚本で、灯台守の女性、ランプを消しに来た役人、嵐が描かれます。セリフはモデルによって演じられ、PDFの言語である英語で行われます。脚本をご自身のものに置き換え、スラグラインをシーンの指示にコピーし、シーンが増えるたびにノードの行を追加すれば、モンタージュがすべてをつなぎます。シーンの価格は長さに応じて決まり、Videoノードで4秒から30秒まで調整できます。
これらは上記ワークフローの生成ファイルであり、モデルが出力したものをそのまま、加工なしで掲載しています。出発点がある場合はそれも表示しています。
レンダリング結果
自分の脚本が撮影されるのをスタッフを探す前に見たい、作家、脚本家、映画を学ぶ学生の皆様。
クラシック形式またはシンプルなプローズ形式で、読みやすいスラッグラインが入ったテキストPDFの脚本:モデルが文書全体を読み込み、そこからビジュアルバイブルを作成します。
脚本のPDFをキャンバスにドロップ
Mediaノードがそれを受け取ります。標準的な脚本フォーマットでも単純なテキストでも構いません。モデルは文書全体を読みます。1ノードにつき最大3つの文書を入れられるので、キャラクターバイブルやシノプシスを別に用意することもできます。
最初のノードにビジュアルバイブルを書かせる
PDFに接続されたTextノードは、文書を読めるモデルを使って、スタイル、キャラクター、セットを3つの短いセクションで返します。これは映画全体をまとめるテキストで、他のすべてのノードがケーブル経由でこれを受け取ります。
キャラクターシートを生成する
2つのImageノードがバイブルを受け取り、それぞれ1人のキャラクターを中立的な背景の4つのアングルで描きます。これらのシートは各シーンの最初のフレームに使われ、シーンをまたいで同じ顔を保つ役割を果たします。キャラクターが増えたら、ノードも1つ増やします。
1シーンにつき1プロンプト、1つの最初のフレーム、1本の映像
各シーンのTextノードはPDFとバイブルを読み、監督プロンプトを書きます。タイムスタンプ付きショット、ショットサイズ、カメラ、引用されたセリフ、音を含みます。最初のフレームが最初のショットの構図を決め、Wan 3.0がそこから映像を撮影します。セリフの演技と音も含まれます。
Montageノードで映画をつなぎ合わせる
3つのシーンはケーブルの順番通りに届きます。モンタージュはブラウザ上でクレジットなしにレンダリングされ、mp4として書き出されます。より長い映画にするには、シーンごとにノードの行を追加し、各映像の長さを変更してください。
同じキャンバスを、別の用途に合わせて調整。各バリエーションは、プロンプトを2〜3行変えるだけです。
これがデモです。3シーン、それぞれ1行のノード、最後にモンタージュ。10シーンの映画にするには、シーンごとに行を複製し、同じバイブルをすべてに接続したままにしてください。これがスタイルと顔を最初から最後まで保つ要となります。
オープニングシーンとキーシーンだけをそれぞれ20秒で撮影し、タイトルカードでつなぎます。キャンバス上のわずか2分で、説明するのではなく演出の意図を見せられます。
小説の1章をPDFで入れることもできます。その場合、バイブルの指示で章をシーンに分割し、スラグラインを考案させます。ワークフローの残りは変わらず、見つかったシーンごとに1つのシーンノードを用意します。
2人のキャラクターによるシーンをテストするには、ノードの行を1つだけにして映像を30秒に伸ばしてください。Wan 3.0は1回の生成で複数のカットをつなぎ、引用されたセリフとその話者を反映します。
Videoノードをリストにある各ショットに対応する追加のImageノードに置き換えれば、一貫したキャラクターのストーリーボードが得られます。映像の価格のごく一部で、撮影前の確認に使えます。
シートは「すべての」シーンの最初のフレームに入れる必要があり、各映像はその最初のフレームから始めなければなりません。Wan 3.0は開始画像があるとすぐに参照画像を無視します。また、バイブルには2〜3つの特徴的な要素を記述し、各シーンのプロンプトで繰り返す必要があります。それがモデルが従う目印です。
2ページ分のシーンは15秒に収まりません。モデルは端折るか、即興を始めてしまいます。映像を最大30秒まで延ばすか、シーンを2つのノードに分割し、それぞれ1行にしてください。
各シーンの指示は脚本内の正確なスラグラインを引用します。PDFを差し替えても指示を変えないと、モデルは存在しないシーンを探してしまいます。生成前に、シーンの見出しをコピーしておいてください。
「The request failed because the input image may contain real person」:Seedance 2.5は現在、生成されたものであっても、人物のフォトリアルな画像を入力(シートや最初のフレーム)として拒否します。そのためこのテンプレートはWan 3.0上で動作し、顔をそのまま受け入れます。プロンプトはSeedanceガイドの形式を保ったままにしておき、ByteDanceが顔の制限を解除したときにノードへ戻してください。
シーンのプロンプトはフランス語の脚本であっても英語で出力されます。これは映像モデルが最もよく従う言語だからです。一方、セリフはプロンプトに引用された言語のまま保たれます。
TextノードはPDF全体を読み、価格はそのサイズに応じて決まります。デモは15秒の3シーンに収まり、ノードの行は3列です。10シーンの短編も同じように、シーンごとに1行、あるいは30秒(Wan 3.0の最大時間)のシーンブロック単位で構築できます。
はい。Wan 3.0はプロンプトに引用されたセリフから、そのテキストの言語で声と口の動きを生成します。デモは脚本の言語である英語です。フランス語の脚本であれば、フランス語のセリフになります。
720pで15秒のシーンはWan 3.0で約125クレジット、キャラクターシートや最初のフレームは10クレジット程度、PDFの読み込みはノードごとに数クレジットです。価格はクリック前に各ノードに表示され、生成に失敗した場合は返金されます。
いいえ。スラグライン、大文字の名前、セリフはモデルが分割する手助けになりますが、地の文だけのテキストでも動作します。バイブルの指示で、シーン分割を提案させることもできます。
はい。生成されたシートを、同じポートに接続したMediaノード内の自分の写真に置き換えるだけです。すでにVideoノードで使われているWan 3.0は、生成された顔と同様に実際の顔もそのまま扱います。
プロンプトに引用されたセリフの言語、つまり脚本の言語で演じられます。デモは英語です。Wan 3.0とSeedance 2.5は約10の言語をネイティブに扱えます。
1つのMontageノードにつき最大24クリップ、240秒までで、ブラウザ上でクレジットなしにレンダリングされます。それを超える場合は、2つ目のMontageノードが続きを担当します。
PDFはプロジェクトとともに保存され、選択したモデルによって読み込まれ、他の用途には一切再利用されません。読み込みの価格はアップロード時にファイルサイズに基づいて確保され、その後実際に読み込まれたトークン数に応じて調整されます。
 Wan 3.0
 Claude Sonnet 5
 Nano Banana Pro
 Seedance 2.5