第一章的摘錄
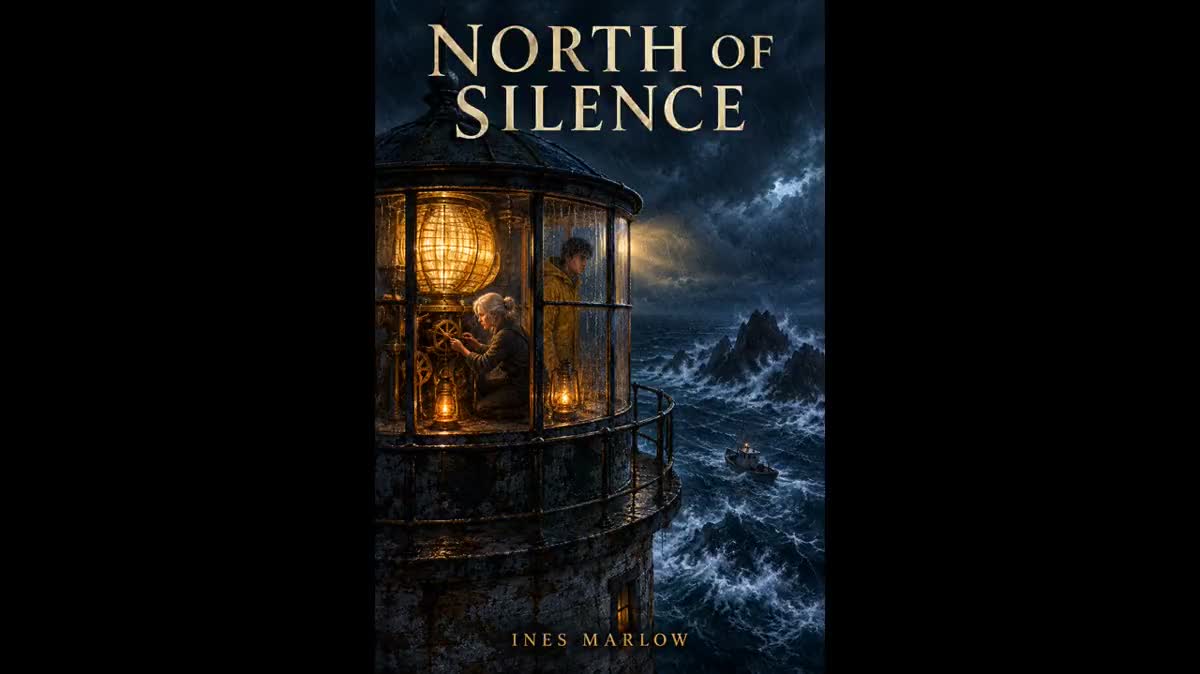
這就是示範內容:逐字抄錄的開頭,一位旁白的聲音,一段配樂,以及顯示在畫面上的封面。您只需替換 PDF 與書名,其餘保留不變,影片就會為您的書重新生成。
把 PDF 章節拖到畫布上:一個文字節點逐字抄錄開頭,一個 ElevenLabs 旁白配音朗讀,一段器樂配樂在下方播放,封面則在 16:9 的剪輯節點中維持顯示:這就是要發布的影片,讓大家聽到第一章。整個工作流程無需帳號即可查看。
真實的工作流程:一部小說的 PDF 第一章放入媒體節點,Claude Sonnet 5 抄錄開頭,ElevenLabs v3 負責旁白,ElevenLabs Music 負責配樂,GPT Image 2.5 Flare 繪製封面,再接上一個剪輯節點。畫面上顯示的文字皆為模型的原始回答,未經修改。
重點摘要
讓人聽到第一章,是一本書最好的宣傳方式。PDF 進入媒體節點,再由文字節點透過其「要分析的圖片或 PDF」連接埠讀取內容,逐字抄錄開頭,不做任何改寫,一直抄到某個段落結尾,且不超過 1,400 個字元:相當於一分半鐘的朗讀長度。
旁白配音節點以 ElevenLabs v3 朗讀這段連接進來的文字,聲音從清單中選出一位旁白。音樂節點依連接進來的指令,創作六十秒的器樂配樂,以低音量在剪輯節點中循環播放。圖片節點使用 GPT Image 2.5 Flare 繪製帶有書名的封面,剪輯節點則在朗讀期間,將封面完整顯示於黑色背景上。
此示範朗讀的是《North of Silence》的開頭,這是專為範例撰寫的原創小說。您只需把 PDF 換成自己的章節,節點中的聲音換掉,封面提示詞中的書名換掉即可。整章內容可分成多個 3,000 字元的旁白配音節點來朗讀,並在剪輯節點中依序接續。封面與預告片完成了這一系列。
這些是上方工作流程所產生的檔案,完全按照模型的原始輸出呈現,未經修飾。若有起始素材,將會標示出來。
生成結果
想在沒有錄音室或配音員的情況下,讓大家聽到第一章的作者與出版社,或是想在製作完整有聲書之前先試聽聲音效果的人。
文字型 PDF 章節,而非掃描檔:文字節點會原樣抄錄文字內容,聲音再逐句朗讀。
拖入 PDF 章節
由媒體節點接收。文字節點抄錄的是開頭本身,不是摘要:這是逐句朗讀的您自己的文字,直到某個段落結尾。
選擇聲音並朗讀
旁白配音節點透過連線接收文字。約有二十種 ElevenLabs v3 音色可選,也可以使用複製的聲音:示範中使用的是 George,一位沉穩的旁白。文字中的 [pause] 或 [whispers] 標籤可以引導演繹方式。
創作配樂並繪製封面
音樂節點依連接進來的指令,創作六十秒的器樂配樂。圖片節點在 3:4 比例的封面上寫出書名,並附上兩則credit(署名)。兩者皆可重新生成,不會影響到旁白。
剪輯並發布
剪輯節點以 16:9 比例將完整的封面置於黑色背景上,一條音軌放旁白,另一條放循環的低音量配樂,並加上結尾淡出效果。全程在瀏覽器中渲染,沒有任何版權標記,並輸出為 mp4 格式。
同一塊畫布,針對不同需求微調:每個變化版本只要改兩三行提示詞。
這就是示範內容:逐字抄錄的開頭,一位旁白的聲音,一段配樂,以及顯示在畫面上的封面。您只需替換 PDF 與書名,其餘保留不變,影片就會為您的書重新生成。
每 3,000 個字元一段文字節點,各配一個旁白配音節點,全部放進同一個剪輯節點:一章十五分鐘的內容,大約用十個節點就能完成朗讀,配樂則在下方循環播放。
從一分鐘的錄音開始,在旁白配音節點中複製您的聲音,再選用它來進行旁白朗讀:第一章由您親自朗讀,無需錄音室。
移除圖片節點與剪輯節點:旁白與配樂可直接從節點輸出為 mp3 格式,適合播客平台或書籍頁面使用。
請文字節點翻譯該段文字,調整旁白配音節點的語言設定,保留原封面:同一部影片就能以英文、西班牙文、德文呈現,並使用相同的聲音。
指令要求逐字抄錄原文。如果模型給出的是摘要,可能是因為讀取到的 PDF 是沒有文字層的掃描檔:請改用文字型 PDF,而不是頁面圖片。
音樂在剪輯節點中音量設為 0.25,以維持在旁白之下。旋律感過強的配樂容易吸引耳朵注意:請在指令中要求無明顯主旋律、不含打擊樂的背景音樂。
剪輯節點的設定會讓整張圖片完整顯示於黑色背景上。若改用「覆蓋」模式,3:4 比例的封面上下方書名可能會被裁掉:摘錄影片請保留「包含」模式。
可以,分段進行:一個旁白配音節點最多可朗讀 3,000 個字元。請文字節點提供下一段,複製旁白配音節點,再把各段依序接續放入剪輯節點中。費用依朗讀的字元數計算。
示範大約花費六十點數:1,400 字元的旁白(約十二點數),六十秒的配樂(約五十點數),封面(兩點數),以及 PDF 讀取(兩到三點數)。每個節點在您點擊之前都會顯示費用。
會的:ElevenLabs v3 會標記逗號、句號,以及以空白行分隔的段落。若要更長的停頓,可使用 [pause] 標籤;若要低聲細語,可使用 [whispers] 標籤。這些標籤本身不會被朗讀出來。
一分半到兩分鐘,也就是 1,400 到 1,800 個字元:足以建立聲音氛圍和場景,又短到能讓人在手機上完整聽完。
可以,在旁白配音節點上進行即可,無需重新生成文字:選擇另一種音色,重新執行朗讀,剪輯節點會自動更新。
不一定,剪輯節點只要任何一段圖片素材即可:作者的照片、場景的插圖皆可。不過帶有書名的封面,仍是最容易被分享的形式。
可以放在書籍頁面、社群媒體,或作為播客的第零集:mp4 輸出為 16:9、1080p,並已混音完成。若使用 9:16 的剪輯節點,則可製作直式版本。
 ElevenLabs v3
 Claude Sonnet 5
 GPT Image 2.5 Flare