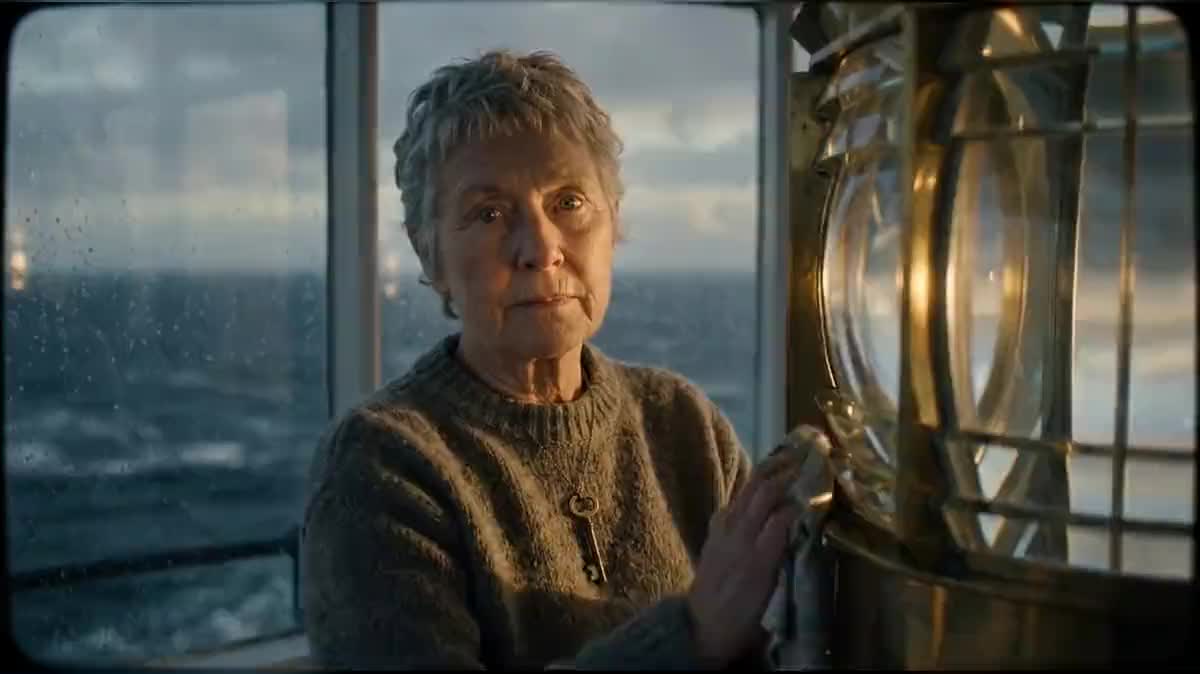
小説の予告動画
これがデモです:4つのショット、4文のボイスオーバー、音楽のベッド。PDFを第一章に置き換え、タイトルをボイスオーバーの指示に入れ、ショットの指示(場所、人物、よそ者、嵐)はそのまま使うか、あなたの物語に合わせて書き換えてください。
章やシノプシスのPDFをキャンバスにドロップすると、1つのTextノードがボイスオーバーを書き、他の4つがそれぞれ1ショットずつ書き、ショットは静止画として描かれてから7秒に動かされ、声がそれを読み、音楽が支え、Montageが30秒の予告動画にまとめ上げます。デモは書き下ろしの章から出発しています。ワークフロー全体はアカウント登録なしで見られます。
実際のワークフロー:小説の第一章のPDFをMediaノードに入れ、ボイスオーバーと4ショットにはClaude Sonnet 5、最初の画像にはNano Banana Pro、7秒の動画4本にはWan 3.0、声にはElevenLabs v3、音楽のベッドにはElevenLabs Musicを使い、最後にMontageノードでまとめています。表示されているテキストはすべてモデルの回答そのもので、手直しはしていません。
概要
書籍の予告動画は30秒に収まります:場所、人物、脅威、タイトル。章やシノプシスのPDFはMediaノードに入り、5つのTextノードが「解析する画像またはPDF」ポートからそれを読み取ります。最初のノードはボイスオーバーを4文で書き、最後の文はタイトルにあてます。残りの4つはそれぞれ7秒のショットを、同じスタイルブロックを先頭に置いて書きます。これが予告動画に一貫した光と質感を与える鍵です。
各ショットはまずNano Banana Proで最初の画像になり、続いてWan 3.0で7秒の無音動画になります。声と音楽はMontageの段で加わります。Voice-overノードは4文をElevenLabs v3で読み上げ、Musicノードはケーブルで渡されたブリーフから30秒のベッドを作曲します。Montageは4つのショットをつなぎ、声を開始から0.5秒後に置き、音楽を低いボリュームに設定します。
デモは「North of Silence」、この例のために書かれたオリジナル小説の第一章から出発しています:灯台守の女性、灯りを消しに来た役人、嵐。PDFをご自身のものに置き換え、タイトルをボイスオーバーの指示に入れれば、あとは同じ流れで進みます。ショットを1つ増やすなら、ノードの列を1本増やすだけです。全体で約350クレジット、そのうち動画が3分の2を占めます。
これらは上記ワークフローの生成ファイルであり、モデルが出力したものをそのまま、加工なしで掲載しています。出発点がある場合はそれも表示しています。
レンダリング結果
撮影なしで書籍発売用の30秒動画を作りたい著者や出版社の方々。
章やシノプシスのテキストPDF、2ページあれば十分です:モデルは文書全体を読み、場所、人物、争点を取り出します。
章やシノプシスのPDFをドロップする
Mediaノードがそれを受け取ります。予告動画には章1つで十分ですし、1ページのシノプシスでも構いません:モデルは文書全体を読み、場所、人物、争点を取り出します。
Textノードにボイスオーバーとショットを書かせる
5つのノードがPDFを読みます。最初のノードはボイスオーバーを4文で書き、残りの4つはそれぞれ共通のスタイル、背景や人物、光、カメラの動きを含む1ショットを書きます。ご自身の書籍に合わせて、タイトルとショットの指示を書き換えてください。
最初の画像を生成し、続いて動画を生成する
各ショットにはImageノードがあり、続けて7秒・無音に設定したVideoノードがあります。動かす前に4枚の画像を確認してください:背景や人物を修正するのはこの段階で、わずか2クレジットで済みます。動かしてからでは遅いのです。
声を読ませ、音楽のベッドを作曲する
Voice-overノードはケーブルで渡されたテキストを受け取り、リストから選んだ声で読み上げます。Musicノードはケーブルで渡されたブリーフから30秒を作曲し、デフォルトではインストゥルメンタルです。両方はMontage内でそれぞれ専用のトラックに入ります。
編集して書き出す
4つのショットはケーブルの順番でつながり、声は開始から0.5秒後に始まり、音楽は低い音量を保ちながらフェードアウトします。編集はブラウザ内でレンダリングされ、クレジットを消費せず、SNSや書籍のページ用にmp4として書き出せます。
同じキャンバスを、別の用途に合わせて調整。各バリエーションは、プロンプトを2〜3行変えるだけです。
これがデモです:4つのショット、4文のボイスオーバー、音楽のベッド。PDFを第一章に置き換え、タイトルをボイスオーバーの指示に入れ、ショットの指示(場所、人物、よそ者、嵐)はそのまま使うか、あなたの物語に合わせて書き換えてください。
人物は登場させません:4つのショットノードには状況を描く画像(問題、行動、結果、テーブルに置かれた本)を求め、ボイスオーバーには鋭い質問を3つ、その後にタイトルを求めます。同じグラフでノンフィクションのティーザーも作れます。
4つのImageノードとVideoノード、そしてMontageを9:16に切り替えます:同じショットがストーリーズやショート動画向けに再構成されます。まず画像を生成してください。横に広い背景は縦型ではうまくいかないことがあります。
ショット1つにノードの列1本です:5番目のショット用に最後の列を複製し、20秒のティーザー用に1本削除してください。Montageはケーブルの通りに追随しますが、ボイスオーバーは最終的なショット数に合わせて書き直す必要があります。
まず原稿から人物のシートを生成し、それをショットのImageノードの画像ポートに接続してください:このようにすると、映画テンプレートと同じように、顔がショットをまたいで保たれます。
4つの指示はすべて同じスタイルブロック(フィルムストック、色調、粒子感)を先頭に持たせる必要があります。このブロックを欠いたショットは違う光になり、予告動画が4本の別の映画から切り出されたように見えてしまいます。
7秒のショット4本で28秒になります。55語を超えるボイスオーバーは尺をオーバーし、Montageがそれを切ってしまいます。40〜55語、ショットごとに1文を目安に指示してください。
Videoノードは無音に設定されています:声と音楽はMontageのトラックから来ます。ショットの音声を再度有効にすると環境音が重なり、声が聞こえにくくなります。場所の音を残したい場合は、音楽ベッドの音量を下げてください。
デモでは約350クレジットです:Wan 3.0による720pの7秒動画4本(各約60クレジット)、最初の画像4枚(各約10クレジット)、30秒の音楽ベッド(約50クレジット)、ボイスオーバーとPDFの解析(数クレジット)。価格はクリックする前に各ノード上に表示されます。
できます:Voice-overノードの指示を「続きを読みたくなるような文を3つ、章からそのまま書き出してください」に変えてください。声はケーブルで渡されたものをそのまま読みます。画面上にテキストのカードを出したい場合は、短いタイトルを画像内に書き込むGPT Image 2.5 FlareでImageノードを追加してください。
Textノードの指示で指定した言語になります。デモでは英語です。ElevenLabs v3は14の言語を読み上げられます:ご自身の言語で指示を書き、それを上手に話せる声を選んでください。
どちらでも使えます。章は具体的な描写と引用できる文を与えてくれます。シノプシスは物語全体の弧を与えてくれるので、争点を伝えるティーザーに向いています。2ページのPDFで十分です。
はい、Voice-overノードのリストから選べます:ElevenLabs v3の声が約20種類、あるいはご自身のライブラリからクローンした声も使えます。デモではDaniel、低く落ち着いたナレーターの声を使っています。
GPT Image 2.5 FlareでImageノードを追加し、プロンプトにタイトルを入れて、Montageの最後のクリップとして3秒、フェード付きで配置してください。Flareは短いタイトルを、崩さずに書き込みます。
ケーブルで渡されたブリーフからElevenLabs Musicがあなたのために作曲するもので、デフォルトはインストゥルメンタルです:既存の曲は使われませんし、ライセンスを申請する必要もありません。ブリーフを変えれば別の雰囲気にできます。
 Wan 3.0
 Claude Sonnet 5
 ElevenLabs v3